 Алгоритм решения задания 14. Часть 1
Учимся решать 15 задания первого типа
Читать
Списочные включения в Python
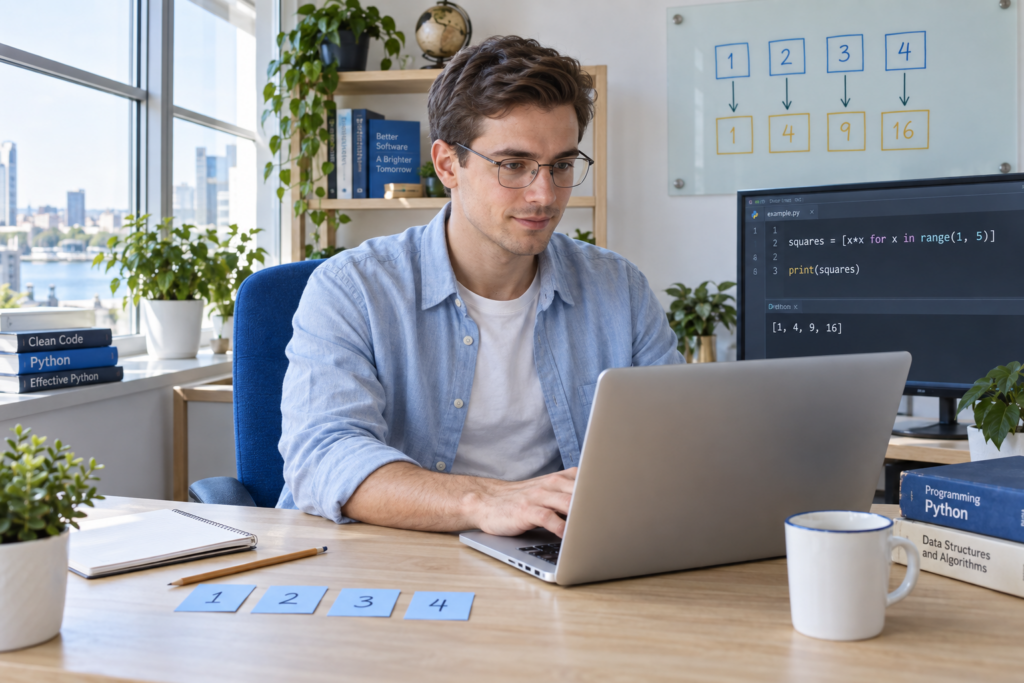
Представьте ситуацию: вам нужно создать список квадратов всех чисел от 1 до 10. Как бы вы это сделали? Скорее всего, написали бы что-то вроде этого:
squares = []
for i in range(1, 11):
    squares.append(i ** 2)
print(squares)
Этот код работает отлично и выдаёт нужный результат: [1, 4, 9, 16, 25, 36, 49, 64, 81, 100]. Но давайте посмотрим на него критически. Нам понадобилось три строки кода, мы создали пустой список, запустили цикл, и в каждой итерации добавляли новый элемент. Это классический подход, который изучают все начинающие программисты.
Однако такую запись можно сделать короче. Метод append() сам по себе работает быстро: Python выделяет для списка память с запасом, поэтому она перераспределяется не при каждом добавлении. Но в цикле всё равно приходится многократно вызывать append() и обращаться к переменным. Списочное включение записывает ту же логику компактнее и часто выполняется быстрее.
Во-вторых, такой код требует больше места и менее читаем. Логика разбита на несколько строк, и чтобы понять, что делает этот фрагмент, нужно прочитать все три строки и мысленно собрать картину воедино. В простых примерах это не проблема, но в реальных программах, где таких конструкций десятки, читаемость кода серьёзно страдает.
Теперь усложним задачу. Допустим, вам нужно получить только чётные квадраты из того же диапазона. Код становится ещё длиннее:
even_squares = []
for i in range(1, 11):
    square = i ** 2
    if square % 2 == 0:
        even_squares.append(square)

print(even_squares)
>>>[4, 16, 36, 64, 100]
Уже четыре-пять строк для такой простой операции! Мы вводим дополнительную переменную square, создаём вложенную структуру с условием и поэтапно наполняем список через append().
С точки зрения быстродействия разница незаметна на маленьких списках из 10 элементов. На тысячах или миллионах элементов списочное включение может дать заметный выигрыш, но конкретное время зависит от версии Python и компьютера.
Кроме того, есть проблема с читаемостью и вероятностью ошибок. В длинном коде легко забыть инициализировать пустой список, случайно использовать неправильное имя переменной или допустить ошибку в отступах. Чем больше строк кода, тем больше мест, где можно ошибиться.
Особенно остро эта проблема стоит на экзаменах, в том числе на ЕГЭ по информатике. Когда у вас ограничено время, каждая минута на счету. Вам нужно не только правильно решить задачу, но и сделать это быстро, оставив время на проверку и другие задания. Написание трёх-четырёх строк кода вместо одной – это не просто лишние символы, это дополнительное время на написание, отладку и проверку.
Именно здесь в игру вступают списочные включения (list comprehensions) – один из самых удобных и полезных инструментов Python. Они позволяют создавать новые списки на основе существующих последовательностей всего в одну строку кода. То, что раньше занимало три-четыре строки с циклами и условиями, теперь можно записать компактно и наглядно.
Списочные включения часто работают быстрее обычного цикла, потому что для их выполнения Python использует более специализированные внутренние операции. При этом они всё равно создают и заполняют новый список, поэтому их главное преимущество в задачах ЕГЭ — краткая и наглядная запись.
В заданиях ЕГЭ по информатике часто встречаются задания на обработку последовательностей: фильтрация данных по условию, преобразование элементов, создание новых структур на основе существующих. Все эти операции значительно упрощаются с использованием списочных включений. Более того, такой код легче проверять – когда логика умещается в одну строку, проще охватить её взглядом и убедиться в правильности.
Далее в статье мы подробно разберём, как работают списочные включения, изучим их синтаксис и научимся применять для решения различных задач. Вы узнаете, как создавать вложенные списочные включения для работы с многомерными структурами, как применять их к словарям и множествам. К концу этой статьи вы будете уверенно использовать этот инструмент и значительно ускорите решение задач по программированию.
Синтаксис списочных включений
Списочное включение – это компактный способ создания нового списка путём применения выражения к каждому элементу итерируемого объекта (например, другого списка, кортежа или результата функции range()). Общий синтаксис выглядит так:
новый_список = [выражение for элемент in последовательность]
Давайте разберём каждую часть этой конструкции:
- Квадратные скобки [] – обозначают, что мы создаём список
- Выражение – это то, что будет применено к каждому элементу (может быть операция, вызов функции или просто сам элемент)
- for элемент in последовательность – цикл, который перебирает все элементы из исходной последовательности
- Элемент – переменная, которая последовательно принимает значения из последовательности
Вернёмся к нашей первой задаче – создать список квадратов чисел от 1 до 10. Вот как это выглядит со списочным включением:
squares = [i ** 2 for i in range(1, 11)]

 print(squares)
>>>[1, 4, 9, 16, 25, 36, 49, 64, 81, 100]
Всего одна строка вместо трёх! Давайте прочитаем этот код как предложение на русском языке: «Создай список, где каждый элемент – это квадрат числа i, для всех i от 1 до 10». Именно так и работает наш мозг, когда мы формулируем задачу, и списочное включение позволяет записать её на Python почти таким же естественным образом.
Вот ещё несколько простых примеров для закрепления:
# Список чисел, умноженных на 3 (обычное выражение)
triples = [x * 3 for x in range(5)]
>>>[0, 3, 6, 9, 12]

# Список длин слов (вызов функции)
words = ['python', 'list', 'comprehension']
lengths = [len(word) for word in words]
>>>[6, 4, 13]

# Преобразование строк в верхний регистр (применение метода)
names = ['анна', 'борис', 'виктор']
upper_names = [name.upper() for name in names]
>>>['АННА', 'БОРИС', 'ВИКТОР']
Списочные включения с условием
Теперь усложним задачу и добавим фильтрацию. Иногда нам нужно не просто преобразовать все элементы, но и отобрать только те, которые удовлетворяют определённому условию. Для этого в списочном включении используется блок if:
новый_список = [выражение for элемент in последовательность if условие]
Условие записывается в конце конструкции после if. В новый список попадут только те элементы, для которых условие истинно (возвращает True).
Вспомним нашу задачу про чётные квадраты. С традиционным подходом код выглядел так:
even_squares = []
for i in range(1, 11):
    square = i ** 2
    if square % 2 == 0:
        even_squares.append(square)

print(even_squares)
А вот как элегантно это решается со списочным включением:
even_squares = [i ** 2 for i in range(1, 11)
                             if (i ** 2) % 2 == 0]

print(even_squares)
>>>[4, 16, 36, 64, 100]
Одна строка вместо пяти! Код стал не только короче, но и понятнее: «Создай список квадратов чисел i от 1 до 10, но только если квадрат чётный». Вся логика видна сразу, не нужно отслеживать создание пустого списка и многократные вызовы append().
Можно сделать код ещё более читаемым, если условие применить к самому числу, а не к его квадрату. Например, мы знаем, что квадрат чётного числа всегда чётен:
even_squares = [i ** 2 for i in range(1, 11) if i % 2 == 0]Здесь мы берём только чётные числа (2, 4, 6, 8, 10) и возводим их в квадрат. Результат тот же, но код проще.
Вот ещё примеры с условиями:
# Положительные числа из списка
numbers = [-5, 3, -1, 8, -3, 10]
positive = [n for n in numbers if n > 0]
>>>[3, 8, 10]

# Слова длиннее 5 символов
words = ['кот', 'собака', 'мышь', 'корова', 'лошадь']
long_words = [word for word in words if len(word) > 5]
>>>['собака', 'корова', 'лошадь']

# Числа, кратные 3
divisible_by_3 = [x for x in range(20) if x % 3 == 0]
>>>[0, 3, 6, 9, 12, 15, 18]
Сравнение производительности
Мы уже говорили, что списочные включения работают быстрее традиционных циклов. Давайте проверим это на практике с помощью модуля timeit, который позволяет точно измерить время выполнения кода.
Напишем функции, в которых будем тестировать производительность двух подходов: с использованием метода append() и списочных включений. Будем создавать список, в который поместим квадраты чётных чисел от 0 до 1 000. Каждую функцию запустим по 10 000 раз для получения более точного результата.
import timeit

# Классический подход с append
def classic_approach():
    result = []
    for i in range(1000):
        if i % 2 == 0:
            result.append(i ** 2)
    return result

# Списочное включение
def list_comprehension():
    return [i ** 2 for i in range(1000) if i % 2 == 0]

# Измеряем время (выполняем каждую функцию 10000 раз)
classic_time = timeit.timeit(classic_approach,
                             number=10000)
comp_time = timeit.timeit(list_comprehension,
                                   number=10000)

print(f"Классический подход: {classic_time:.4f} сек")
print(f"Списочное включение: {comp_time:.4f} сек")

>>>Классический подход: 1.0476 сек
>>>Списочное включение: 0.9610 сек
На большинстве компьютеров вы увидите, что списочное включение работает немного быстрее. Точное соотношение будет меняться от запуска к запуску, поэтому важнее сам вывод: компактная запись обычно не только удобнее читается, но и быстрее выполняется.
Почему списочные включения быстрее?
Причина в том, что Python выполняет списочные включения с меньшими накладными расходами. Когда интерпретатор видит такую конструкцию, он:
- Использует специализированную операцию добавления элемента в список
- Не выполняет отдельный вызов
append()на каждой итерации - Сокращает накладные расходы на выполнение цикла в Python
Кроме того, списочные включения более читаемы и компактны, что снижает вероятность ошибок и ускоряет написание кода – критически важное преимущество на экзаменах.
Вложенные списочные включения
До этого момента мы работали с простыми одномерными списками – последовательностями элементов, которые можно перебрать одним циклом. Однако в реальных задачах, особенно в заданиях ЕГЭ, часто приходится работать с более сложными структурами: матрицами, таблицами, вложенными списками. Для обработки таких данных нужны вложенные циклы, и списочные включения отлично справляются и с этой задачей.
Представим простую задачу: создать таблицу умножения для чисел от 1 до 3. Традиционный подход с вложенными циклами выглядит так:
multiplication_table = []
for i in range(1, 4):
    row = []
    for j in range(1, 4):
        row.append(i * j)
    multiplication_table.append(row)

print(multiplication_table)
>>>[[1, 2, 3], [2, 4, 6], [3, 6, 9]]
Этот код работает, но занимает шесть строк и требует создания двух пустых списков – внешнего и внутреннего. Логика размазана по нескольким уровням вложенности, и чтобы понять, что происходит, нужно мысленно отследить работу обоих циклов.
Ещё один распространённый случай – «развёртывание» двумерной структуры в одномерную. Например, у нас есть список списков, и мы хотим получить все элементы в одном плоском списке:
matrix = [[1, 2, 3], [2, 4, 6], [3, 6, 9]]
flat_list = []
for row in matrix:
    for element in row:
        flat_list.append(element)

print(flat_list)
>>>[1, 2, 3, 2, 4, 6, 3, 6, 9]
Снова четыре строки для такой простой операции, плюс необходимость отслеживать два уровня вложенности циклов.
Вложенные списочные включения позволяют записать вложенные циклы в одну строку. Общий синтаксис выглядит так:
# Для создания двумерного списка (списка списков)
[[выражение for внутренний_элемент in внутренняя_последовательность]
  for внешний_элемент in внешняя_последовательность]

# Для «разворачивания» двумерного списка в одномерный
[выражение for внешний_элемент in внешняя_последовательность
  for внутренний_элемент in внутренняя_последовательность]
Важно понимать порядок циклов. В списочном включении циклы записываются в том же порядке, что и в традиционном коде: сначала внешний цикл, затем внутренний.
Сравним синтаксис классических вложенных циклов и вложенных списочных включений (код из первого примера):
prod = []
for row in range(1, 4):
    inner_list = []
    for col in range(1, 4):
        inner_list.append(row * col)
    prod.append(inner_list)
А с использованием вложенных списочных включений его можно сократить до одной строки:
prod = [[row * col for col in range(1, 4)]
               for row in range(1, 4)]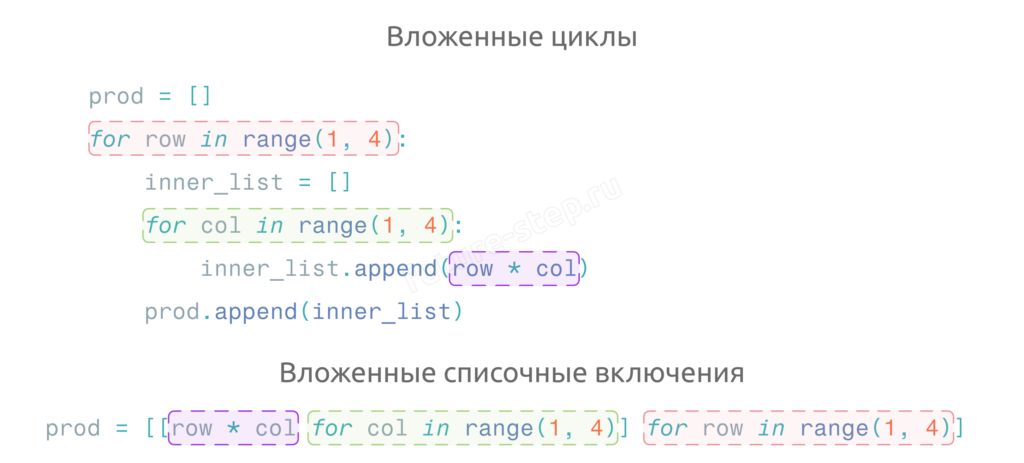
Давайте прочитаем это выражение изнутри наружу:
row * col— выражение, которое вычисляется для каждой пары (row, col)for col in range(1, 4)— внутренний цикл, создающий элементы одной строки[row * col for col in range(1, 4)]— создаёт один список (одну строку таблицы)for row in range(1, 4)— внешний цикл, создающий строки[[...] for row in range(1, 4)]— создаёт список строк таблицы (список списков)
Теперь проверим работу вложенных списочных включений на обратной операции: превратим двумерный список в одномерный:
matrix = [[1, 2, 3], [2, 4, 6], [3, 6, 9]]

flatten = [el for row in matrix for el in row]

print(flatten)
>>>[1, 2, 3, 2, 4, 6, 3, 6, 9]
Обратите внимание: здесь у нас один список (одинарные квадратные скобки), но два цикла for. Мы не создаём список списков, а собираем все элементы в один плоский список.
И классический пример: транспонирование матрицы. Транспонирование – это операция, при которой строки и столбцы матрицы меняются местами.
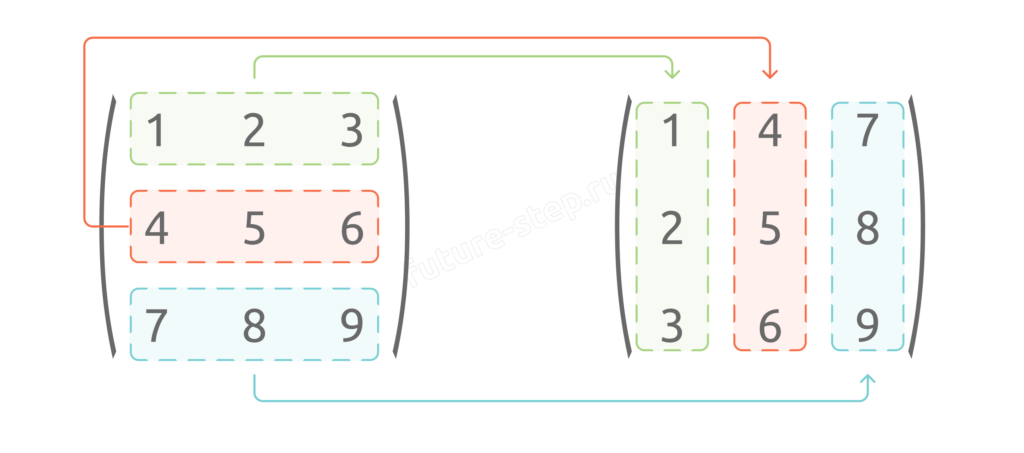
Рассмотрим сначала подход через вложенные циклы:
matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
transposed = []

for j in range(len(matrix[0])):
    row = []
    for i in range(len(matrix)):
        row.append(matrix[i][j])
    transposed.append(row)

print(transposed)
>>> [[1, 4, 7], [2, 5, 8], [3, 6, 9]]
Со списочным включением это выглядит намного лаконичнее:
matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
transposed = [[row[col] for row in matrix]
              for col in range(len(matrix[0]))]

print(transposed)
>>> [[1, 4, 7], [2, 5, 8], [3, 6, 9]]
Списочные включения со словарями
Представьте задачу: у вас есть словарь с результатами экзамена по разным предметам, и нужно создать новый словарь, содержащий только те предметы, по которым ученик набрал больше 75 баллов, при этом увеличив каждый балл на 5 (допустим, за особые достижения).
exam_scores = {
    'математика': 82,
    'русский': 68,
    'информатика': 91,
    'физика': 73,
    'английский': 85}

high_scores = {}
for subject, score in exam_scores.items():
    if score > 75:
        high_scores[subject] = score + 5

print(high_scores)
>>>{'математика': 87, 'информатика': 96, 'английский': 90}
Четыре строки кода для относительно простой операции! Мы создаём пустой словарь, перебираем все пары ключ-значение, проверяем условие и добавляем отфильтрованные данные с преобразованием.
Или возьмём другую частую задачу: у нас есть два списка – один с названиями фруктов, другой с их ценами, и нужно создать из них словарь. Классический подход:
products = ['яблоки', 'бананы', 'апельсины']
prices = [100, 80, 120]

price_dict = {}
for i in range(len(products)):
    price_dict[products[i]] = prices[i]

print(price_dict)
>>>{'яблоки': 100, 'бананы': 80, 'апельсины': 120}
Снова несколько строк, работа с индексами, создание пустого словаря. Как и в случае со списками, этот подход работает, но требует больше времени на написание и больше внимания при проверке – легко ошибиться с индексами или забыть инициализировать пустой словарь.
Наверное, вы уже нашли сходство этих ситуаций с теми, что мы описывали в самом начале. Да, похожий механизм можно применять и к другим структурам данных, например к словарям. Такие конструкции называются словарными включениями (dictionary comprehensions).
Словарные включения очень похожи на списочные, но вместо квадратных скобок используются фигурные, а вместо одного выражения указываются ключ и значение через двоеточие:
новый_словарь = {ключ: значение for элемент in последовательность}
Как и в списочных включениях, можно добавить условие для фильтрации:
новый_словарь = {ключ: значение for элемент in последовательность if условие}
При работе с существующим словарём обычно используется метод items(), который возвращает пары (ключ, значение):
новый_словарь = {ключ: новое_значение for ключ, значение in старый_словарь.items()}
Давайте вернёмся к нашей первой задаче и решим её с помощью словарного включения:
exam_scores = {
    'математика': 82,
    'русский': 68,
    'информатика': 91,
    'физика': 73,
    'английский': 85}

high_scores = {subject: score + 5 for subject, score
               in exam_scores.items()
               if score > 75}

print(high_scores)
>>>{'математика': 87, 'информатика': 96, 'английский': 90}
Одна строка вместо четырёх! Код читается как естественное предложение: «Создай словарь, где для каждого предмета балл увеличен на 5, но только если исходный балл больше 75».
А теперь перейдём ко второму примеру, с ценами на фрукты. Для создания словаря из двух списков удобно использовать функцию zip(), которая «склеивает» два списка в пары:
products = ['яблоки', 'бананы', 'апельсины']
prices = [100, 80, 120]

price_dict = {product: price for product, price
              in zip(products, prices)}

print(price_dict)
>>>{'яблоки': 100, 'бананы': 80, 'апельсины': 120}
Функция zip() берёт первый элемент из первого списка и первый элемент из второго списка, создавая пару (‘яблоки’, 100), затем вторые элементы (‘бананы’, 80) и так далее. Словарное включение превращает эти пары в словарь.
Сравните с традиционным подходом: вместо четырёх строк с работой с индексами у нас одна понятная строка. По принципу работы словарные включения аналогичны списочным: можно применять функции и методы к элементам, использовать условия, тернарные операторы и создавать вложенные словарные включения.
Списочные включения с множествами
Давайте снова представим задачу: у вас есть список оценок учеников класса, и нужно найти все уникальные оценки, которые встречаются в списке, причём интересуют только оценки выше тройки. Традиционный подход с циклом выглядит так:
grades = [5, 4, 3, 5, 4, 5, 2, 4, 3, 5, 4, 5, 3, 4, 5]

unique_high_grades = set()
for grade in grades:
    if grade > 3:
        unique_high_grades.add(grade)

print(unique_high_grades)
>>>{4, 5}
Четыре строки кода для простой операции. Мы создаём пустое множество, перебираем все оценки, проверяем условие и добавляем элементы методом add(). Как и с пустыми списками и словарями, это работает, но требует больше кода и времени.
Уже догадываетесь к чему мы идём?
Да, механизм включений можно применять и к множествам. По аналогии со словарными они называются множественными включениями (set comprehensions).
Множественные включения по синтаксису почти идентичны списочным, но вместо квадратных скобок используются фигурные:
новое_множество = {выражение for элемент in последовательность if условие}
Главное не спутать их со словарными: в словарных включениях есть двоеточие между ключом и значением ({ключ: значение}), а в множественных – только одно выражение ({выражение}).
Давайте решим первую задачу с помощью множественного включения:
grades = [5, 4, 3, 5, 4, 5, 2, 4, 3, 5, 4, 5, 3, 4, 5]
unique_high_grades = {grade for grade in grades if grade > 3}

print(unique_high_grades)
>>>{4, 5}
Как вы уже могли понять, работают множественные включения аналогично списочным и словарным. Для примера давайте рассмотрим несколько ситуаций их применения.
Найдём все делители числа 24:
n = 24
divisors = {i for i in range(1, n + 1) if n % i == 0}

print(divisors)
>>>{1, 2, 3, 4, 6, 8, 12, 24}
Извлечём все уникальные цифры из строки:
text = "В 2024 году было 365 дней, а температура достигала +42 градусов"
digits = {char for char in text if char.isdigit()}

print(digits)
>>>{'0', '2', '3', '4', '5', '6'}
Найдём все возможные остатки от деления чисел от 1 до 20 на 7:
remainders = {x % 7 for x in range(1, 21)}

print(remainders)
>>>{0, 1, 2, 3, 4, 5, 6}
Итоги
Мы научились создавать новые структуры данных, применяя выражения и фильтры к существующим последовательностям, что делает программы компактнее и понятнее. Включения для списков, словарей и множеств позволяют заменить громоздкие циклы одной строкой кода, который работает быстрее и содержит меньше возможностей для ошибок.
На ЕГЭ по информатике эти навыки дают реальное преимущество: вместо пяти-семи строк с циклами вы пишете одну, экономя время на написание и проверку кода. Компактная запись позволяет быстрее находить ошибки и легче держать всю логику решения в голове.
Особенно полезными списочные включения окажутся для решения заданий 9 ЕГЭ по информатике программным способом. В следующей статье мы разберём несколько примеров на каждый тип этого задания и покажем, как применять изученные в этой статье техники для быстрого и надёжного получения ответов.