 Алгоритм решения задания 16. Часть 2
Учимся решать 16 задания второго типа
Читать
Оптимизация рекурсии в Python
В прошлой статье мы разобрали, что такое базовый и рекурсивный случаи, стек вызовов и ограничение на глубину рекурсии.
Теперь перейдём к другой проблеме: одни и те же значения могут вычисляться много раз. Из-за этого даже короткая рекурсивная функция может работать очень долго.
В прошлой статье цепочка факториала была линейной: из каждого вызова появлялся ровно один следующий. А вот у чисел Фибоначчи каждый вызов порождает два новых, поэтому цепочка превращается в быстро разрастающееся дерево.
Здесь поможет мемоизация — сохранение уже найденных результатов. Важно: она уменьшает число повторных вычислений, но не отменяет ограничение на глубину одной цепочки вызовов.
Сначала разберём мемоизацию вручную, а затем перейдём к готовому декоратору @lru_cache.
Проблема избыточных вычислений
Рекурсия может быть красивым и эффективным решением, но у неё есть серьёзная проблема: рекурсивные функции часто выполняют одни и те же вычисления многократно.
Давайте разберём это на примере чисел Фибоначчи — одной из самых известных рекурсивных последовательностей.
Кто такой Фибоначчи и откуда взялась последовательность
Фибоначчи — прозвище Леонардо Пизанского, математика, жившего примерно в 1170–1250 годах. В 1202 году он завершил книгу Liber Abaci, посвящённую вычислениям и практической арифметике.
В одной из задач книги рассматривалось размножение пар кроликов. Каждая взрослая пара каждый месяц приносила новую пару, а молодая пара начинала размножаться позднее.
Количество пар по месяцам образовывало последовательность 1, 1, 2, 3, 5, 8 и далее. Каждый новый результат складывался из количества молодых и взрослых пар, то есть из двух предыдущих чисел.
Важно не превращать историю в миф об «изобретении» последовательности. Похожие числа встречались у индийских математиков раньше, а задача Леонардо сделала их особенно известными в европейской математике.
Вспомним, как устроена эта последовательность. Каждое число равно сумме двух предыдущих:
F(0) = 0
F(1) = 1
F(n) = F(n-1) + F(n-2)
Получаем последовательность: 0, 1, 1, 2, 3, 5, 8, 13, 21, 34…
Иногда нумерацию начинают с F(1) = 1 и F(2) = 1. Тогда сами числа те же, но их номера сдвигаются. В программной задаче всегда используйте базовые случаи именно из условия.
Рекуррентная формула не сообщает готовое F(n), зато объясняет, как получить его из меньших значений. Поэтому она идеально переводится в рекурсивную функцию.
Напишем простую рекурсивную функцию:
def fib(n):
    if n < 2:
        return n
    return fib(n - 1) + fib(n - 2)
Выглядит просто и понятно! Всего три строчки. Но давайте посмотрим, что происходит при вызове этой функции.
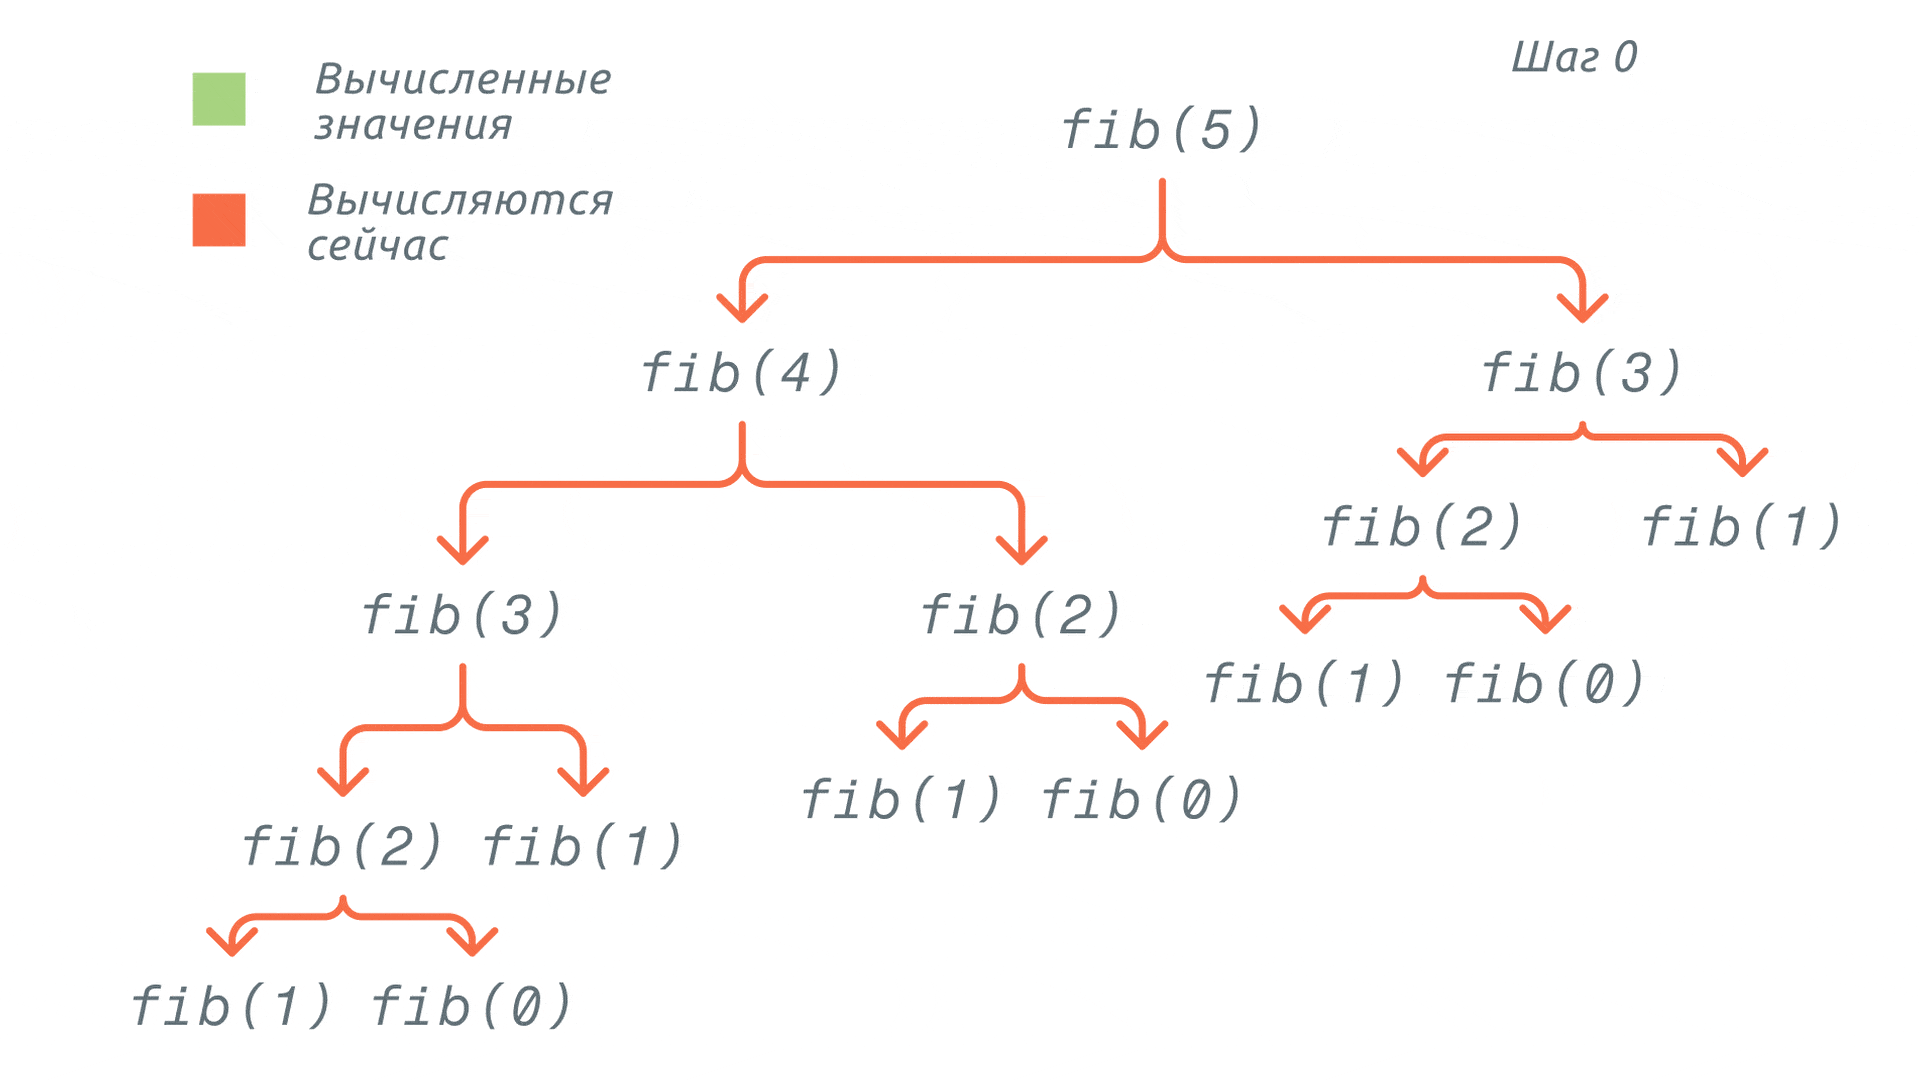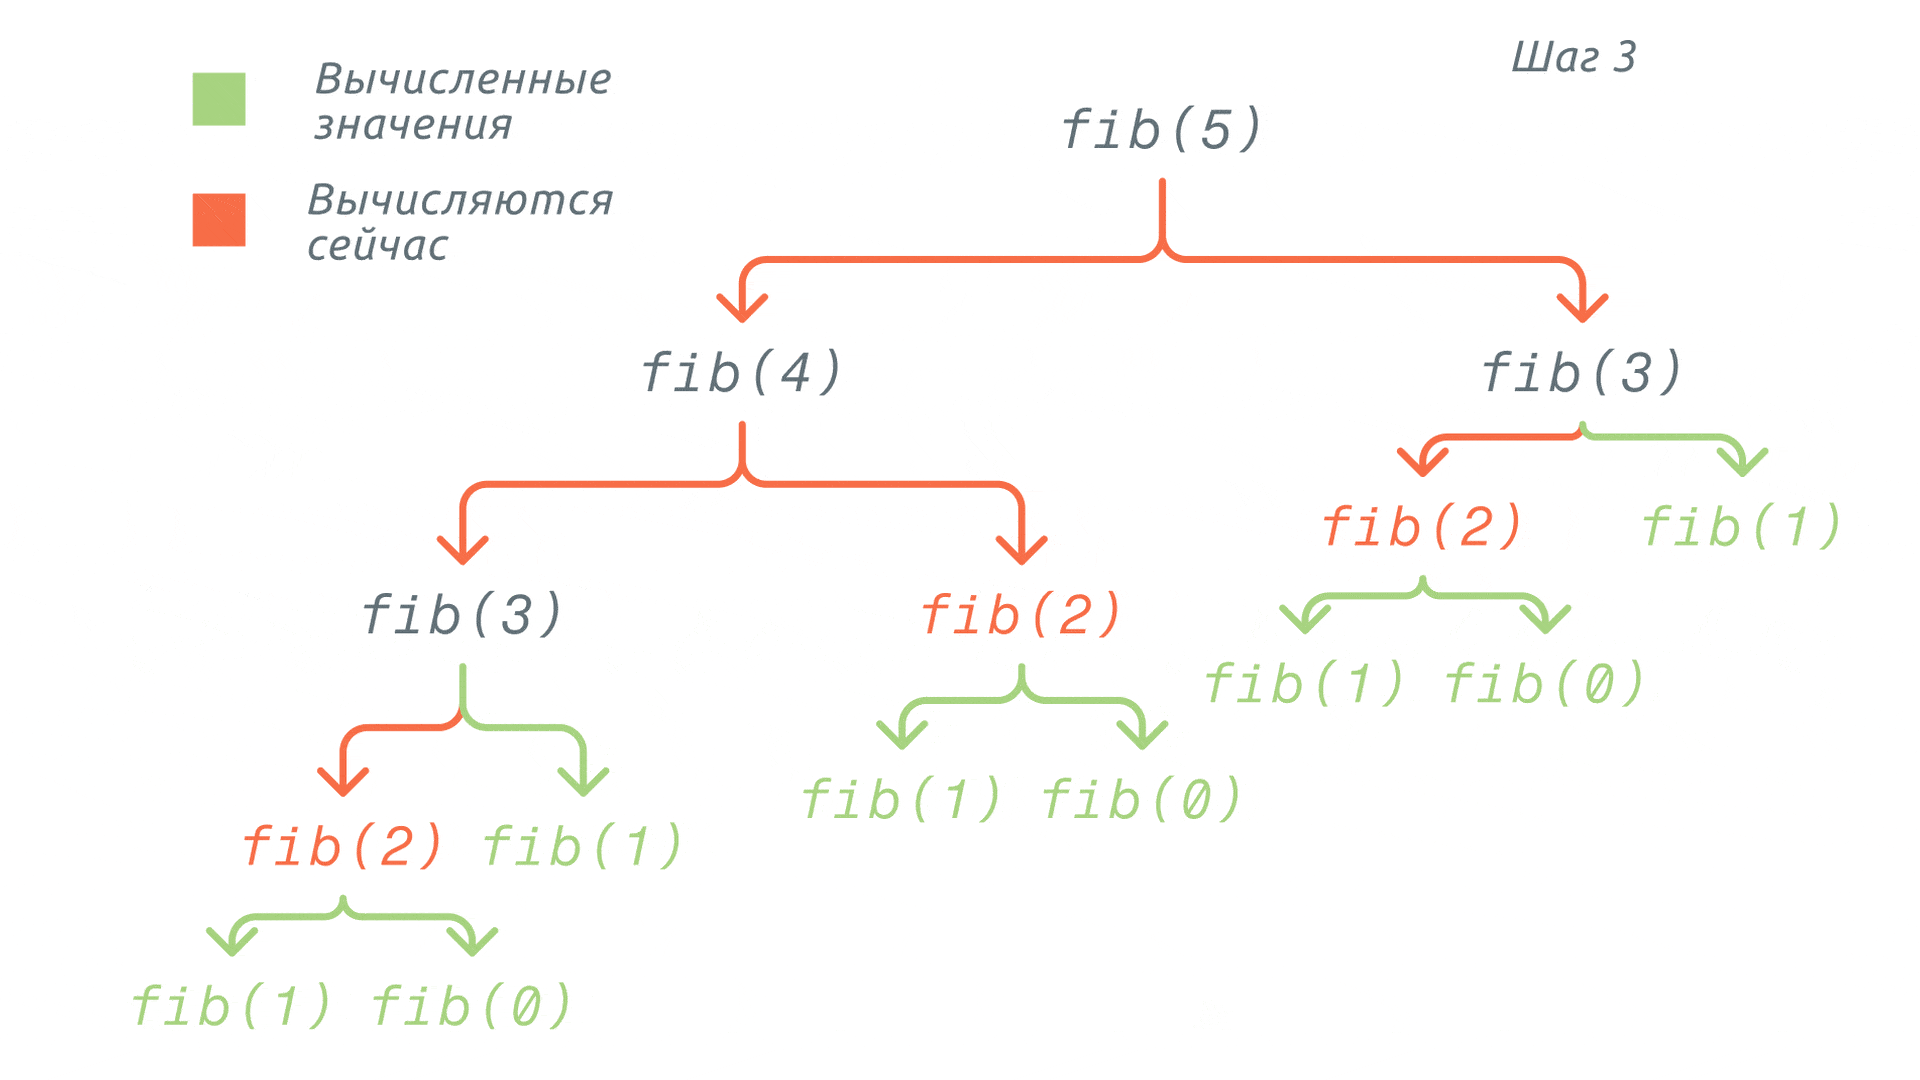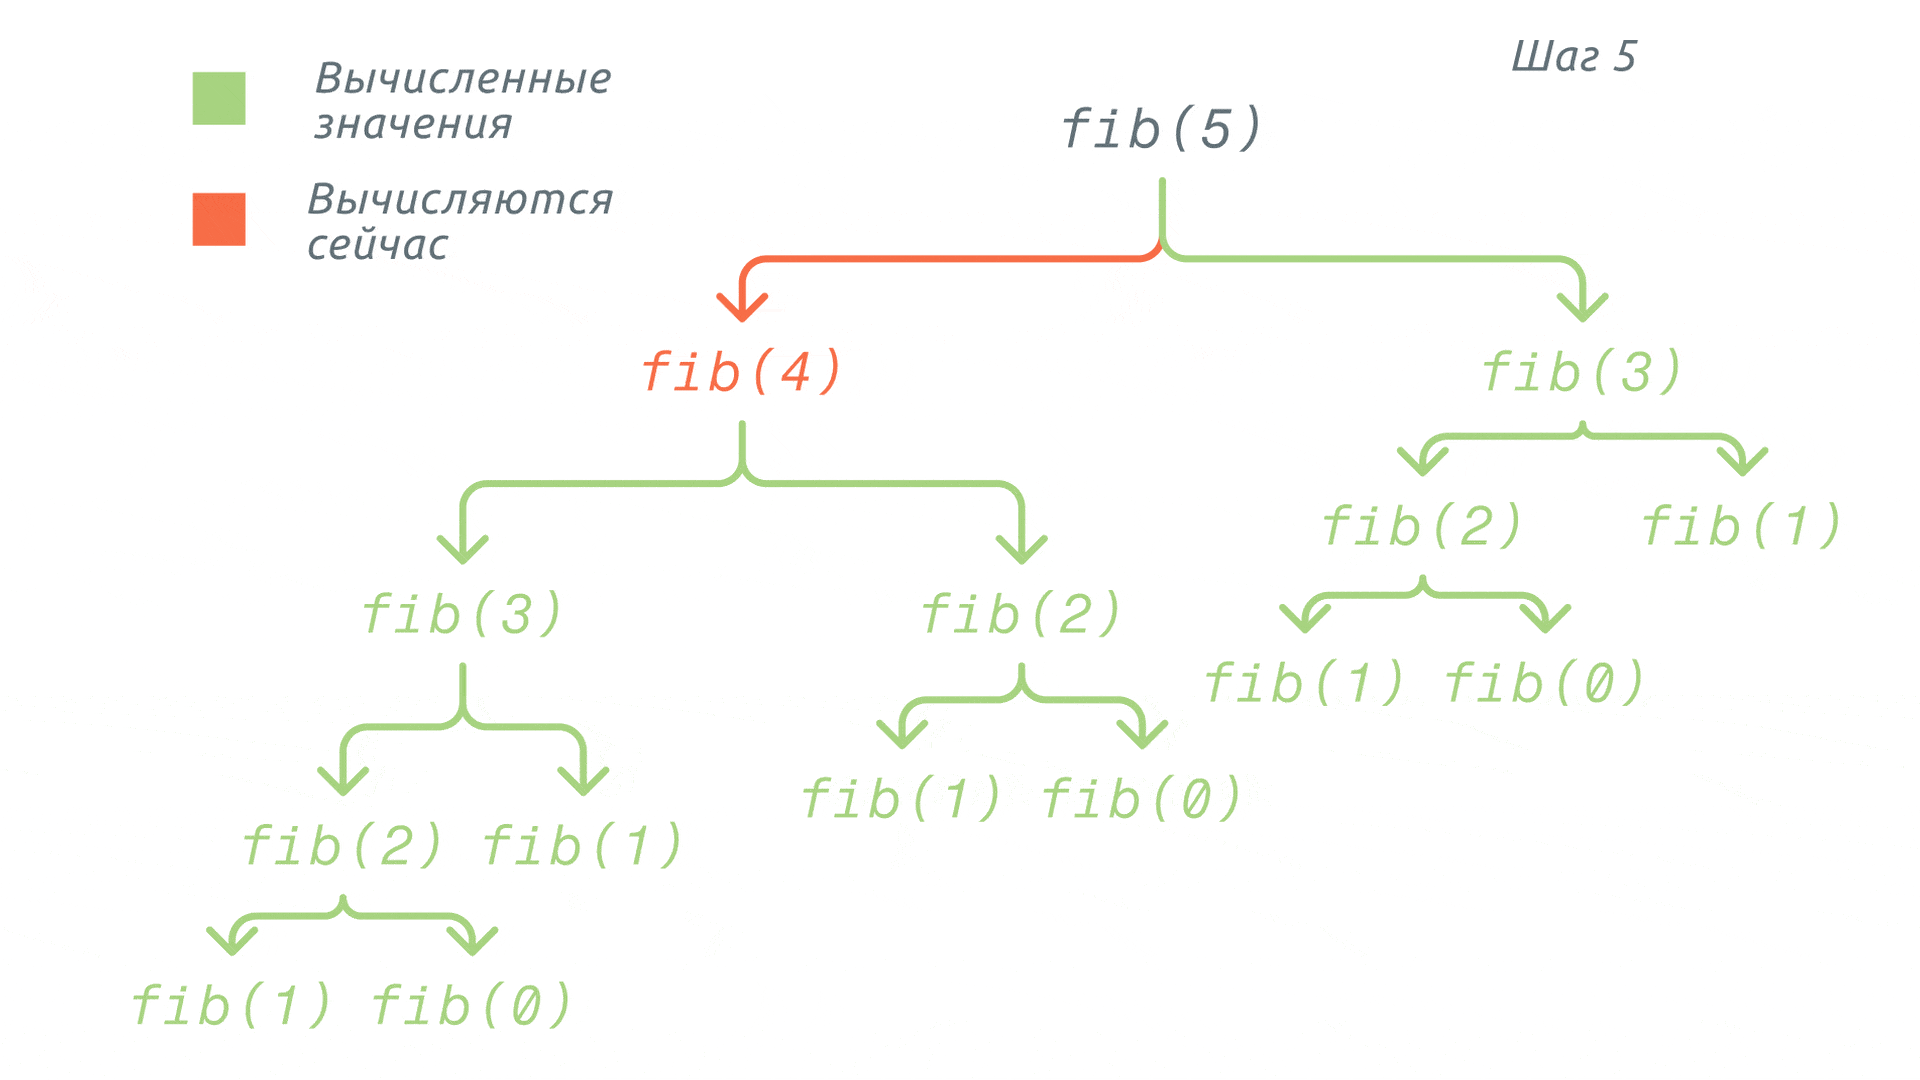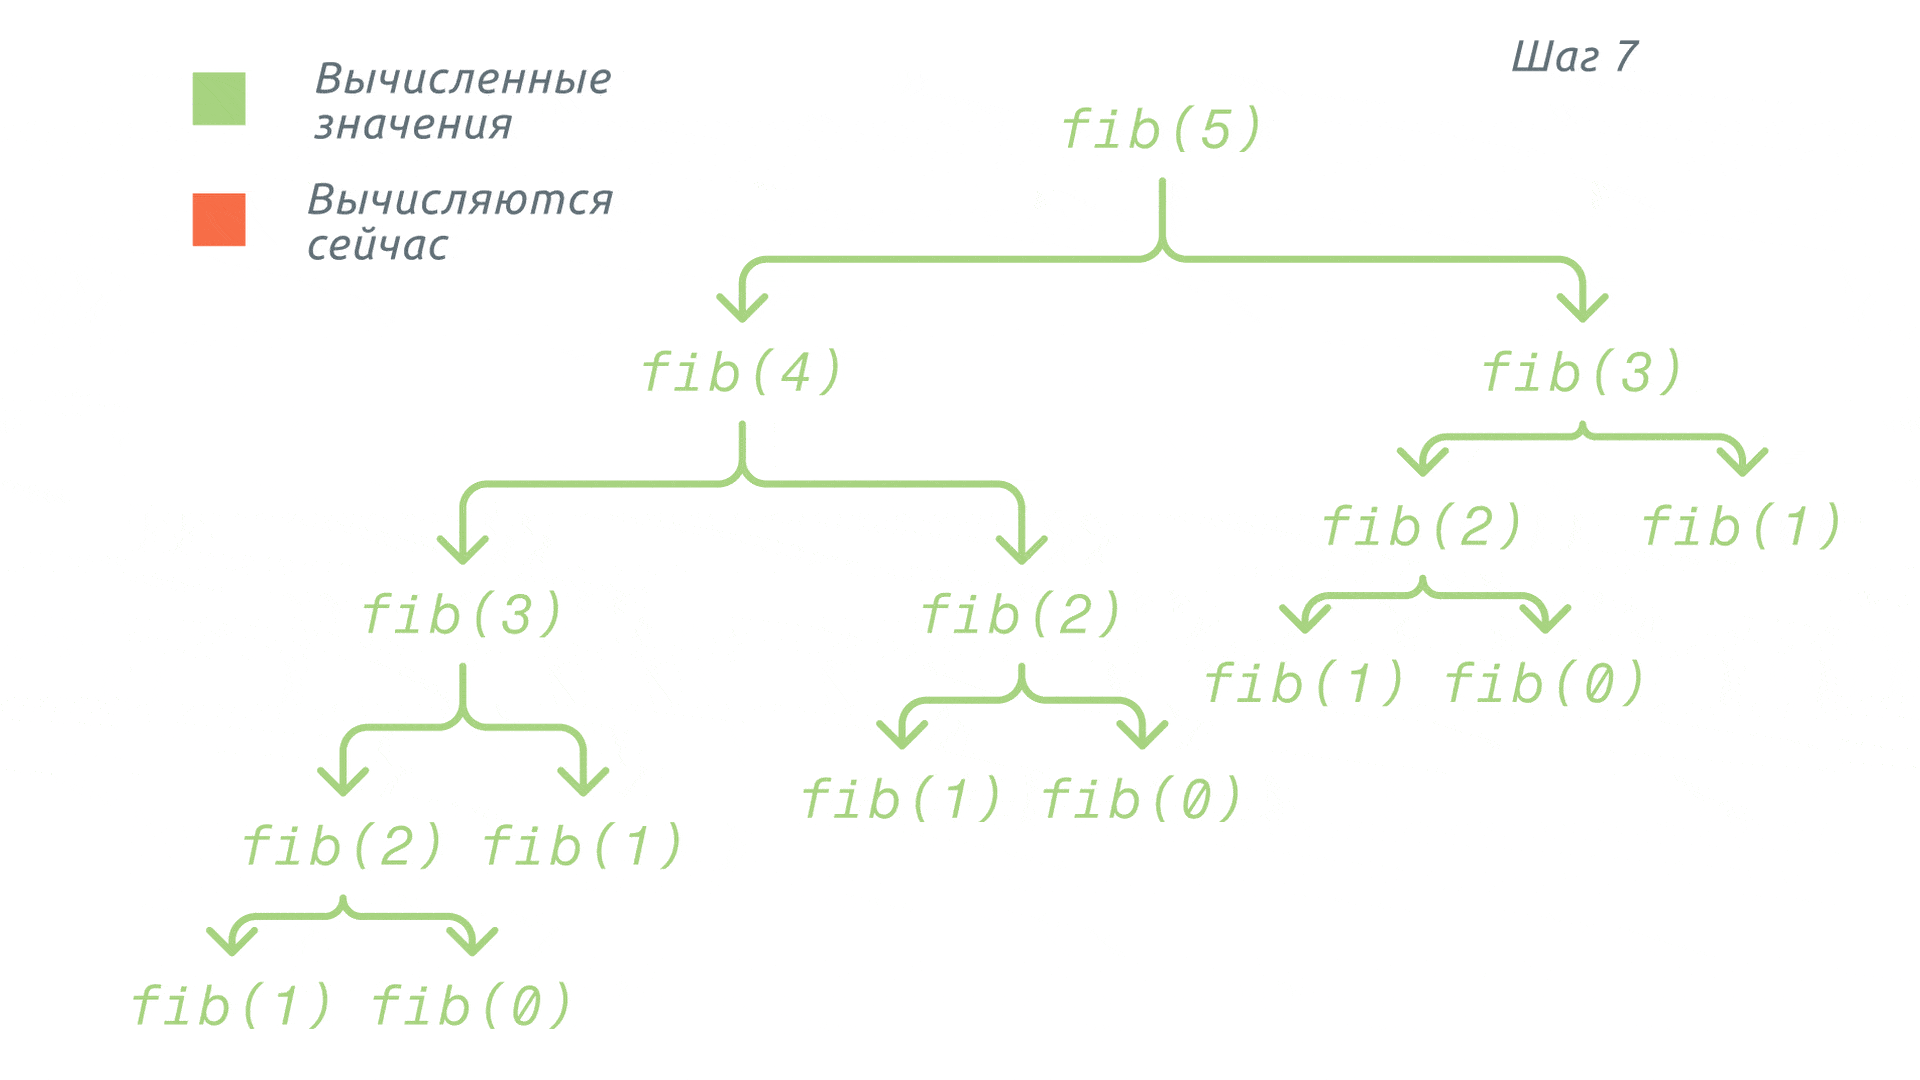
Чтобы найти fib(5), функция вычисляет fib(4) и fib(3).
- Для
fib(4)нужныfib(3)иfib(2). - Но
fib(3)уже понадобилось при вычисленииfib(5). Обычная рекурсия не помнит его результат и считает значение заново. - Так возникает дерево повторяющихся вызовов:
Вызов функции fib(5) можно представить в виде такого дерева:
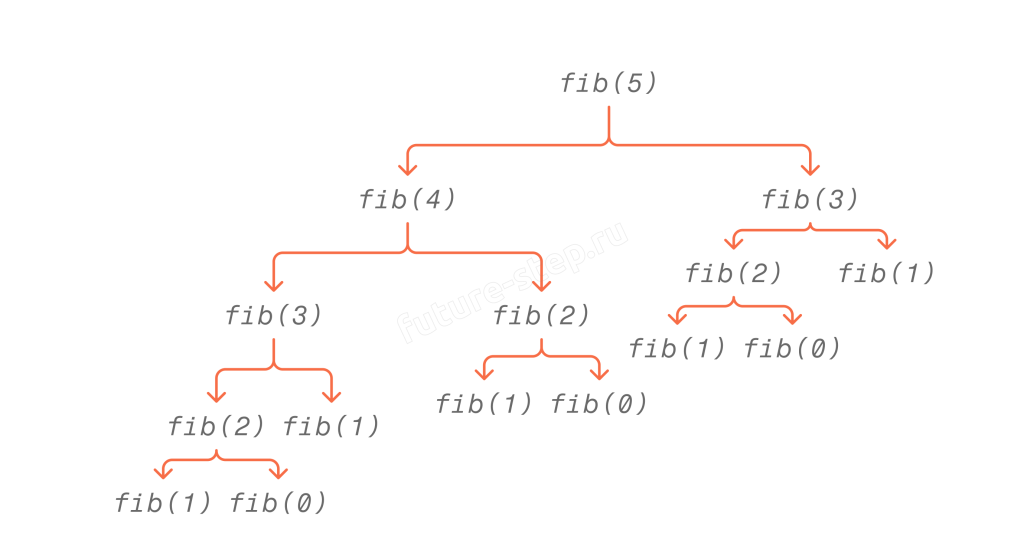
Обратите внимание на повторения:
fib(3)вычисляется 2 разаfib(2)вычисляется 3 разаfib(1)вычисляется 5 разfib(0)вычисляется 3 раза
И это только для пятого элемента! Представьте, что будет с тридцать пятым.
Замерим время на fib(35). Цифра будет зависеть от компьютера, но разница с кешированной версией всё равно будет огромной:
import time
def fib(n):
    if n < 2:
        return n
    return fib(n - 1) + fib(n - 2)
# Замеряем время выполнения
start = time.perf_counter()
result = fib(35)
end = time.perf_counter()
print(f'35 элемент ряда Фибоначчи: {result}')
print(f'Время выполнения: {(end - start) * 1000:.3f} миллисекунд')

>>>35 элемент ряда Фибоначчи: 9227465
>>> Время выполнения: 5149.575 миллисекунд
На одном компьютере это займёт доли секунды, на другом — несколько секунд. Дело не в точном числе, а в экспоненциальном росте количества вызовов.
Почему так медленно? Количество вызовов функции растёт экспоненциально:
fib(10)— 177 вызововfib(20)— 21 891 вызовfib(30)— 2 692 537 вызововfib(35)— 29 860 703 вызоваfib(40)— более 331 миллиона вызовов!
Грубая оценка сложности — O(2ⁿ): с увеличением n число вызовов растёт очень быстро.
Это верхняя грубая оценка. Более точный рост связан с самой последовательностью Фибоначчи, но для экзамена важен вывод: добавление нескольких единиц к n умножает работу, а не просто немного её увеличивает.
Глубина одной ветви при этом растёт линейно, примерно до n. Значит, у наивной функции две разные проблемы: огромное количество повторов и возможное ограничение глубины при больших n.
Проблема: мы постоянно вычисляем одни и те же значения снова и снова.
Решение: нужно сохранять уже вычисленные результаты, чтобы не считать их повторно. Эта техника называется кеширование или мемоизация.
Кеширование
Кеш — это место, где сохраняют результат дорогой операции, чтобы при повторном запросе не выполнять её ещё раз. Цена такого ускорения — дополнительная память и необходимость понимать, когда сохранённый ответ остаётся актуальным.
Для начала разберёмся, как работает кеширование. Вы с кешем сталкиваетесь каждый день, но при этом можете даже не подозревать о его работе. Разберём самый типичный пример использования кеша — кеширование страниц веб-сайтов.
Когда вы первый раз заходите на сайт, браузер загружает все изображения, видео, стили, скрипты с удалённого сервера. Это может занять несколько секунд. Пока всё загружается, вы видите «заглушки» — серые прямоугольники вместо картинок.
Но при повторном посещении этого же сайта страница загружается мгновенно! Почему?
Браузер сохранил все эти файлы на вашем компьютере в специальное место — кеш. Теперь вместо того, чтобы снова скачивать всё с сервера, браузер просто берёт файлы из кеша.
Или можем рассмотреть такой пример: пользователь запрашивает у приложения какие-то данные из базы данных. Что при этом происходит внутри приложения?
Без кеширования:
- Пользователь нажимает на товар (запрос к приложению)
- Приложение отправляет запрос к базе данных
- База данных ищет информацию
- Данные передаются обратно в приложение
- Приложение показывает информацию пользователю
Всё это может занять 1-2 секунды.
С кешированием:
- Пользователь нажимает на товар
- Приложение проверяет: «А может, я уже загружал эту информацию?»
- Если да — сразу показывает из кеша (порядка 0,01 секунды)
- Если нет — загружает из базы и сохраняет в кеш
При повторном обращении к тому же товару ответ приходит мгновенно.
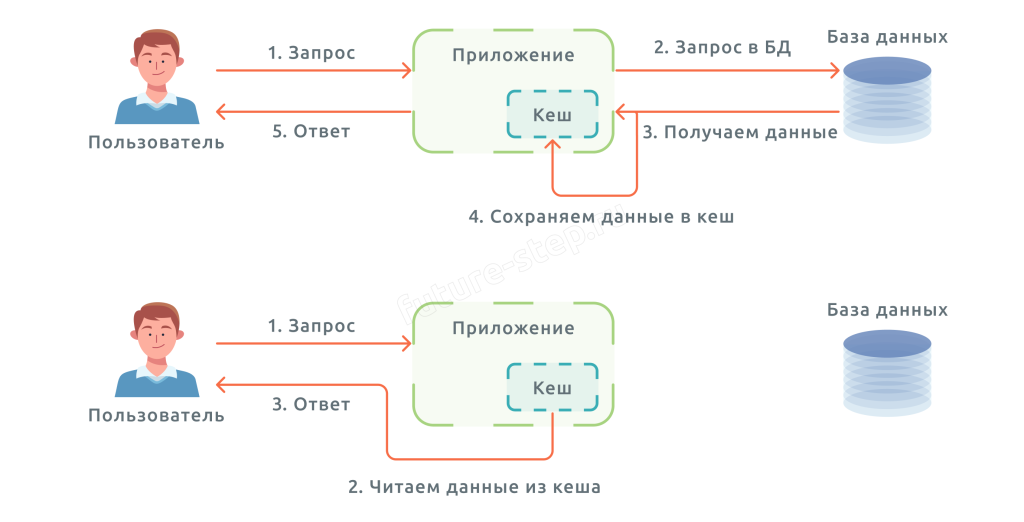
Теперь мы готовы дать определение термину «кеширование». Кеширование — это техника ускорения доступа к данным путём их временного хранения в быстродоступном месте.
Основная идея:
- При первом обращении — получаем данные из медленного источника и сохраняем в кеше
- При повторном обращении — берём данные из кеша (это быстро!)
- Экономим время и ресурсы
Мемоизация
У мемоизации более узкий смысл. Ключом служат аргументы функции, а значением — результат её работы. Для пары «одинаковые аргументы → одинаковый ответ» сохранённое значение можно безопасно использовать повторно.
Поэтому мемоизация лучше всего подходит чистым функциям, результат которых зависит только от аргументов. Если функция читает текущее время, случайное число или изменяемый внешний список, старый результат может оказаться неверным.
Мемоизация — это частный случай кеширования, который применяется для оптимизации вычислений в функциях.
Простыми словами: если функция с одними и теми же аргументами всегда возвращает один и тот же результат, зачем вычислять его заново? Можно просто запомнить результат при первом вызове и потом брать из памяти.
Давайте применим мемоизацию к нашей функции вычисления чисел Фибоначчи.
Идея:
- Мы будем добавлять в кеш (в нашем случае — просто в словарь) значения уже вычисленных элементов
- Получается, что мы доходим до вызова функции
fib(0)и добавляем её результат в словарь - Аналогично будет и с
fib(1) - Далее для вычисления значения
fib(2)мы уже не будем вызывать функцииfib(1)иfib(0), а просто возьмём значения из нашего словаря
И так будем проделывать с каждым вызовом вплоть до нужного значения. Таким образом, значительно снизим не только количество вызовов функций, но и время выполнения всей программы. Весь этот процесс проиллюстрирован ниже (gif-анимация):
Давайте реализуем это в коде. Алгоритм у нас будет следующий:
- Создание кеша. В нашем случае это будет просто словарь, в который мы помещаем результаты работы функций. Ключами в словаре будут аргументы функции.
- Проверка кеша. При вызове функции проверяем, есть ли в словаре значение с ключом, равным аргументу функции.
- Если значение в кеше найдено – возвращаем его. Если нет, то вычисляем.
- После вычисления возвращаем полученное значение, перед этим сохранив его в кеше.
Проследим работу алгоритма на вычислении пятого числа Фибоначчи.
Сначала рекурсия доходит до базовых значений и сохраняет пары 1: 1 и 0: 0. Из них получается 2: 1, затем 3: 2.
Когда второй ветке снова понадобится fib(2) или fib(3), функция найдёт ключ в словаре и сразу вернёт готовое число. Нового дерева под этим узлом уже не появится.
В конце в кеше окажутся значения для аргументов от 0 до 5. Каждое действительно вычислено один раз, а все повторные обращения стали быстрыми чтениями из словаря.
Получаем такую программу:
import time


def fib(n):
    if n < 2:
        return n
    return fib(n - 1) + fib(n - 2)


fib_cache = {}


def fib_cached(n):
    if n in fib_cache:
        return fib_cache[n]

    if n < 2:
        result = n
    else:
        result = fib_cached(n - 1) + fib_cached(n - 2)

    fib_cache[n] = result
    return result


start = time.perf_counter()
fib(35)
end = time.perf_counter()
print(f'Без кеша: {(end - start) * 1000:.3f} мс')

start = time.perf_counter()
fib_cached(35)
end = time.perf_counter()
print(f'С кешем: {(end - start) * 1000:.3f} мс')

>>>Без кеша: 5149.575 мс
>>>С кешем: 0.195 мс
Как видите, с кешем программа отработала гораздо быстрее. Ведь теперь каждое из 36 различных значений fib(0), fib(1), …, fib(35) вычисляется всего один раз. Повторные обращения сразу получают уже готовый результат из словаря.
Временная сложность становится O(n): нужно получить n + 1 различных значений. Память тоже растёт как O(n), потому что результаты и рекурсивные фреймы нужно где-то хранить.
Мемоизация убрала ветвление, но не уменьшила максимальную длину пути от fib(n) к базовому случаю. Поэтому при очень большом n всё ещё может понадобиться предварительный прогон для получения начальных значений или итеративное решение.
Встроенные инструменты Python для кеширования
Мы научились делать кеширование вручную, но это не очень удобно. Нужно создавать словарь, проверять его, сохранять результаты… Много кода.
К счастью, в Python уже есть готовые инструменты для кеширования! Они находятся в модуле functools.
functools — это встроенный модуль Python, который содержит полезные утилиты для работы с функциями.
Вот некоторые из них:
Для кеширования:
@lru_cache— декоратор для кеширования с LRU-стратегией@cache(Python 3.9+) — упрощённая версия без ограничения размера
Для работы с функциями:
wraps— сохраняет метаданные при создании декораторовpartial— создаёт новые функции с частично применёнными аргументамиreduce— применяет функцию ко всем элементам последовательности
Сейчас мы сосредоточимся на @lru_cache — готовом декораторе для мемоизации.
Декораторы
В Python функции являются объектами: их можно передавать в другие функции и возвращать как результат. На этой возможности и строятся декораторы.
Запись @decorator над определением функции равносильна строке function = decorator(function), выполненной после создания function. Декоратор получает исходную функцию и возвращает новую обёрнутую функцию.
У lru_cache есть параметры, поэтому сначала вызывается lru_cache(maxsize=None). Этот вызов возвращает декоратор, который затем оборачивает fib.
Прежде чем использовать @lru_cache, нужно понять, что такое декоратор.
Декоратор — это специальная функция, которая изменяет поведение другой функции, не меняя её код.
Представьте, что у вас есть обычная функция:
def greet(name):
    return f"Привет, {name}!"
А теперь вы хотите, чтобы она выводила время вызова. Можно переписать функцию, добавив туда код с временем. А можно использовать декоратор!
import time

def time_decorator(func):
    def wrapper(*args, **kwargs):
        # Просто выводим текущее время
        print(f"[{time.strftime('%H:%M:%S')}]", end=" ")
        return func(*args, **kwargs)
    return wrapper

@time_decorator
def greet(name):
    return f"Привет, {name}!"

print(greet("Алиса"))
>>>[13:37:00] Привет, Алиса!
Но можете особо не погружаться в тему с декораторами. Для задания 16 не требуется самостоятельно писать такую обёртку. Но важно понимать синтаксис: строка с @lru_cache выполняется один раз при создании функции и заменяет её кешированной версией.
Декоратор @lru_cache
Итак, резюмируем прошлую главу: @lru_cache — это уже готовый декоратор из модуля functools. Он автоматически кеширует результаты функции, если её аргументы можно использовать как ключи кеша. Целые числа из задания 16 для этого замечательно подходят.
Что означает LRU?
LRU расшифровывается как Least Recently Used (наименее недавно использованный).
Это стратегия управления кешем. Представьте, что у вас есть полка на 10 книг (кеш на 10 элементов). Когда полка заполнится и вам нужно поставить новую книгу, какую старую убрать?
LRU-стратегия говорит: убирай ту книгу, которую дольше всего не брали.
Это логично, ведь если книгу давно не читали, скорее всего, она и дальше никому уже и не понадобится. А часто используемые книги останутся на полке.
Так же работает и @lru_cache:
- Сохраняет результаты функций в кеше
- Когда кеш заполняется, удаляет самые старые неиспользуемые результаты
- Часто используемые результаты остаются в кеше
Теперь давайте опробуем декоратор @lru_cache в деле. Самый простой способ — просто добавить декоратор к функции:
from functools import lru_cache

@lru_cache()
def fib(n):
    if n < 2:
        return n
    return fib(n - 1) + fib(n - 2)
Всё! Теперь функция автоматически кеширует свои результаты. Никаких словарей, никаких проверок — Python делает всё за вас.
При первом fib(10) декоратор ещё не знает ответа и передаёт вызов исходному коду. После вычисления он связывает аргумент 10 с результатом 55.
При следующем fib(10) тело функции уже не запускается: обёртка находит готовый ответ. Именно поэтому кеширование срабатывает без ручной проверки словаря внутри fib.
Проверим скорость:
import time
from functools import lru_cache


@lru_cache(maxsize=None)
def fib(n):
    if n < 2:
        return n
    return fib(n - 1) + fib(n - 2)


start = time.perf_counter()
result = fib(35)
end = time.perf_counter()

print(f'35-й элемент ряда Фибоначчи: {result}')
print(f'Время выполнения: {(end - start) * 1000:.3f} мс')
>>>35-й элемент ряда Фибоначчи: 9227465
>>>Время выполнения: 0.155 мс
Встроенный декоратор даёт тот же самый эффект, что и наш «рукописный» алгоритм кеширования в функции fib_cached: каждое значение вычисляется один раз.
Параметры @lru_cache
Декоратор @lru_cache можно настраивать с помощью двух параметров: maxsize и typed.
Параметр maxsize (по умолчанию 128) — максимальное количество сохранённых результатов в кеше.
Когда кеш заполняется, самые старые неиспользуемые результаты удаляются, чтобы освободить место для новых.
from functools import lru_cache

# Кеш на 256 элементов
@lru_cache(maxsize=256)
def function_1(x):
    return x * 2

# Кеш на 1000 элементов
@lru_cache(maxsize=1000)
def function_2(x):
    return x * 3

# Неограниченный кеш
@lru_cache(maxsize=None)
def function_3(x):
    return x * 4
Важные моменты:
- Значение
maxsizeвыбирают по количеству различных наборов аргументов. Требования брать именно степень двойки нет. - При
maxsize=Noneзаписи не вытесняются. Для короткой программы на ЕГЭ это удобно, но в долго работающей программе кеш с большим числом уникальных аргументов может занять много памяти. - Больший кеш хранит больше результатов, но расходует больше памяти. Меньший кеш — наоборот.
Параметр typed=True гарантирует, что аргументы разных типов, например 1 и 1.0, будут кешироваться отдельно. В задании 16 этот параметр обычно не нужен.
У кешированной функции есть методы для наблюдения и очистки. Вызов fib.cache_info() покажет количество попаданий, промахов и сохранённых записей, а fib.cache_clear() удалит накопленные результаты.
Попадание, или hit, означает, что ответ нашли в кеше. Промах, или miss, означает, что такого набора аргументов ещё не было и функцию пришлось вычислить.
Для короткого экзаменационного скрипта очистка обычно не нужна. Но при нескольких независимых экспериментах старый кеш может скрыть реальное время первого вычисления, поэтому перед новым замером его стоит очистить.
Аргументы lru_cache должны быть хешируемыми (это понятие от слова «хеш», а не «кеш»!). Целые числа, строки и кортежи подходят, а изменяемый список использовать как ключ нельзя. В задании 16 аргументы обычно целые, поэтому ограничение почти незаметно.
Начиная с Python 3.9 можно использовать @cache. Он эквивалентен неограниченному кешу и короче, однако в учебных решениях задания 16 часто встречается привычный @lru_cache(maxsize=None).
Итоги
Мемоизация запоминает результат функции для уже встречавшихся аргументов. В дереве Фибоначчи она оставляет по одному вычислению для каждого n и сокращает экспоненциальное число вызовов до линейного.
В Python эту работу берёт на себя декоратор @lru_cache(maxsize=None). Он ускоряет повторные обращения, но не делает короче одну глубокую цепочку и расходует память на сохранённые ответы.
Всегда проверяйте, действительно ли одинаковые аргументы дают одинаковый результат, и не путайте ускорение с уменьшением глубины. В следующей статье применим рекурсию, цикл и мемоизацию к первому типу задания 16.