 Алгоритм решения задания 16. Часть 2
Учимся решать 16 задания второго типа
Читать
Рекурсия в Python
Скоро мы перейдём к заданию 16 ЕГЭ по информатике. В нём функция задана через саму себя, а нам нужно вычислить её значение. Сначала разберёмся, что именно происходит при таком вызове.
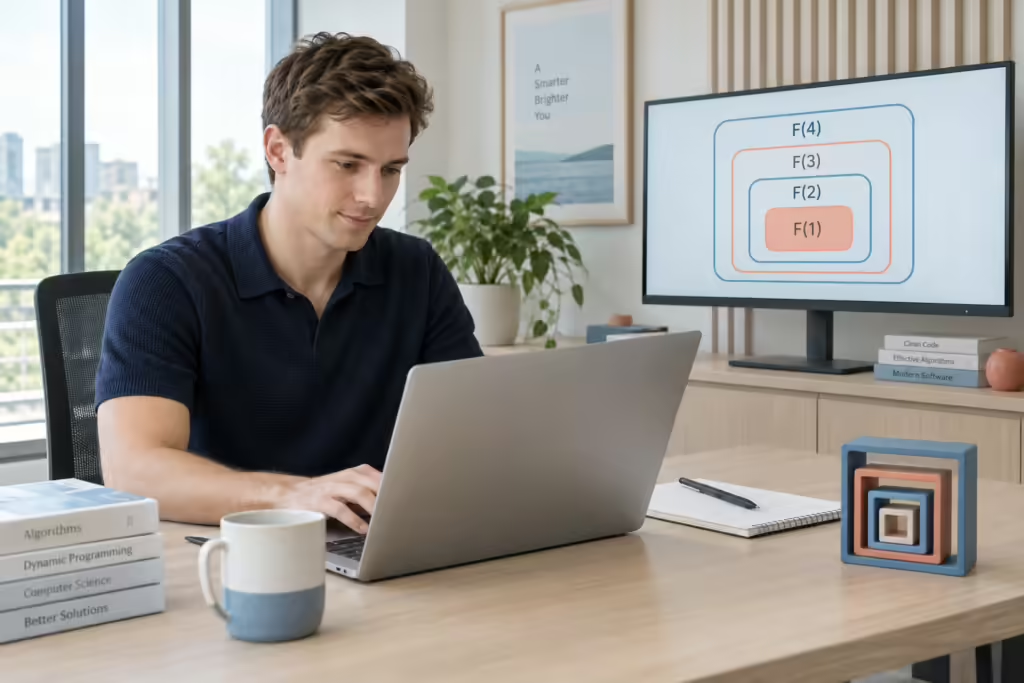
В обычной функции мы привыкли видеть прямую дорогу: получили аргументы, выполнили команды, вернули ответ. Рекурсивная функция в середине работы открывает новый вызов самой себя, поэтому дорога превращается в цепочку вложенных вычислений.
На первый взгляд кажется, будто функция пытается воспользоваться ответом, которого ещё нет. На деле каждый новый вызов получает собственное значение аргумента и решает более маленькую версию исходной задачи.
Наша задача — не просто выучить слово «рекурсия», а научиться видеть три вещи: где функция остановится, как изменяется аргумент и в каком порядке возвращаются отложенные вычисления.
Что такое рекурсия
Зачем функции вызывать саму себя
Представьте папку «Учёба». В ней лежат файлы и другие папки, внутри которых снова могут оказаться файлы и папки. Заранее неизвестно, сколько уровней вложенности нам встретится.
Можно написать цикл для первого уровня, вложенный цикл для второго, ещё один для третьего. Но стоит структуре стать глубже, как заранее написанных циклов уже не хватит.
Рекурсивный обход формулируется естественнее: обработай текущую папку, а для каждой вложенной папки выполни тот же алгоритм. Глубину определяют сами данные, а не количество циклов в программе.
Рекурсия — это способ решения, при котором функция вызывает саму себя с другим аргументом. Каждый вызов решает ту же задачу, но для более простого случая.
Слово «другой» здесь принципиально. Если функция вызывает себя с тем же аргументом и состояние задачи не меняется, она никогда не доберётся до остановки.
Иногда рекурсия бывает косвенной: функция A вызывает B, а B снова вызывает A. В задании 16 чаще встречается прямая рекурсия, когда F обращается к F, но стек работает одинаково в обоих случаях.
Чтобы рекурсия работала, в функции обязательны две части:
- базовый случай — готовый ответ, при котором нового вызова нет;
- рекурсивный случай — вызов той же функции с аргументом, который приближает нас к базовому случаю.
Есть и третья проверка, без которой первые две бесполезны: каждый рекурсивный шаг должен приближать аргумент к базовому случаю.
Например, при условии n > 1 вызов factorial(n − 1) движется к единице. А factorial(n + 1), наоборот, уводил бы аргумент всё дальше и дальше.
Первый учебный пример: обратный отсчёт
Начнём с функции, которая печатает числа от n до нуля. Здесь хорошо виден спуск, но пока нет сложных вычислений на обратном пути.
def countdown(n):
    print(n)
    if n == 0:
        return
    countdown(n - 1)


countdown(3)
Сначала печатается 3, затем запускается countdown(2), потом countdown(1) и countdown(0). На нуле выполняется return, новые вызовы прекращаются.
После этого завершаются ожидающие вызовы для 1, 2 и 3. Они уже ничего не печатают после рекурсивной строки, поэтому внешне мы замечаем только спуск: 3, 2, 1, 0.
Возьмём факториал. Напомню: 5! = 5 · 4 · 3 · 2 · 1 = 120.
То же самое можно записать через меньший факториал: n! = n · (n − 1)!. Но эта формула не может продолжаться бесконечно, поэтому задаём остановку: 1! = 1.
Сначала функция спускается к базовому случаю:
factorial(5) → factorial(4) → factorial(3) → factorial(2) → factorial(1)На этом этапе умножения ещё не закончены. Каждый вызов ждёт, пока более глубокий вернёт результат.
Когда factorial(1) возвращает 1, начинается обратный путь:
factorial(1) = 1
factorial(2) = 2 · 1 = 2
factorial(3) = 3 · 2 = 6
factorial(4) = 4 · 6 = 24
factorial(5) = 5 · 24 = 120
Важно: factorial(2), factorial(3) и остальные функции не вызываются заново. Их уже запущенные вызовы просто продолжают работу в обратном порядке.
Поэтому рекурсию удобно мысленно делить на два этапа: спуск к базовому случаю и возврат с готовыми значениями.
При чтении любой рекурсивной формулы задайте себе три вопроса:
- Где базовый случай?
- Как изменяется n в следующем вызове?
- Точно ли аргумент когда-нибудь попадёт в базовый случай?
Если остановки нет или n движется не в ту сторону, Python в итоге завершит программу с RecursionError.
В реальных программах рекурсия полезна, когда заранее неизвестна глубина вложенности: например, папка может содержать другие папки, а те — ещё одни.
Но для задания 16 главное не обход папок, а умение аккуратно прочитать базовую и рекурсивную части формулы.
Как записать рекурсию в Python
Теперь перенесём оба случая в код. Будем считать факториал только для целых n ≥ 0. По определению 0! = 1, поэтому базовый случай удобно записать как n <= 1.
def factorial(n):
    if n < 0:
        raise ValueError("Факториал определён для n ≥ 0")
    if n <= 1:          # базовый случай
        return 1
    return n * factorial(n - 1)  # рекурсивный случай
Как читать return с рекурсивным вызовом
Строка return n * factorial(n - 1) не может сразу вернуть число: значение правой части пока неизвестно. Текущий вызов запоминает множитель n и ждёт результата более глубокого вызова.
Важно различать «вызвать функцию» и «закончить функцию». В момент factorial(5) → factorial(4) первый вызов не исчезает. Он приостанавливается на строке return.
Разберём вызов factorial(5) по шагам.
- При n = 5 условие n <= 1 ложно, поэтому функция должна вернуть
5 · factorial(4). - Но сначала ей нужно узнать
factorial(4), поэтому текущее умножение откладывается. - То же происходит для 4, 3 и 2. Лишь
factorial(1)сразу возвращает готовую единицу. - После этого отложенные умножения выполняются снизу вверх: 2 · 1, затем 3 · 2, 4 · 6 и 5 · 24.
Рекурсия особенно удобна, если задача естественно распадается на подзадачи того же типа:
- обход деревьев и вложенных папок;
- алгоритмы «разделяй и властвуй»;
- перебор вариантов: поиск пути, судоку, расстановка ферзей.
Рекурсия и цикл
Когда выбирать рекурсию?
Одну и ту же задачу часто можно решить и рекурсией, и обычным циклом (итеративным подходом).
Для простой последовательности вычислений цикл обычно проще и экономнее по памяти. Рекурсия выигрывает, когда она повторяет саму структуру задачи и делает код понятнее.
Вот тот же факториал через цикл:
def factorial_iterative(n):
    result = 1
    for i in range(1, n + 1):
        result *= i
    return result
Далее давайте разберем несколько примеров решения стандартных задач обоими методами: итеративным и рекурсивным. И выясним, когда же лучше использовать рекурсию, а когда итеративное вычисление.
Задача: найти сумму всех чисел от 1 до n.
Итеративный подход:
def sum_iterative(n):
    total = 0
    for i in range(1, n + 1):
        total += i
    return total
print(sum_iterative(5))
>>>15Рекурсивный:
def sum_recursive(n):
    # Базовый случай
    if n == 1:
        return 1
    # Рекурсивный случай
    else:
        return n + sum_recursive(n - 1)
print(sum_recursive(5))
>>>15
Задача: найти сумму всех элементов в списке.
Итеративный:
def sum_list_iterative(lst):
    total = 0
    for num in lst:
        total += num
    return total
print(sum_list_iterative([1, 2, 3, 4, 5]))
>>>15Рекурсивный:
def sum_list_recursive(lst):
    # Базовый случай: пустой список
    if not lst:
        return 0
    # Рекурсивный случай: первый элемент + сумма остальных
    else:
        return lst[0] + sum_list_recursive(lst[1:])
print(sum_list_recursive([1, 2, 3, 4, 5]))
>>>15
Задача: развернуть строку задом наперёд.
Итеративный подход:
def reverse_iterative(s):
    result = ""
    for char in s:
        result = char + result  # Добавляем символ в начало
    return result
print(reverse_iterative("hello"))
>>>ollehРекурсивный:
def reverse_recursive(s):
    # Базовый случай: пустая строка или один символ
    if len(s) <= 1:
        return s
    # Рекурсивный случай: переставляем первый символ в конец
    else:
        return reverse_recursive(s[1:]) + s[0]
print(reverse_recursive("hello"))
>>>olleh
Уже можно сделать некоторые выводы. Используйте рекурсию, когда:
- Задача естественным образом разбивается на подзадачи того же типа
- Работаете с древовидными структурами (деревья, файловая система)
- Решаете задачи типа «разделяй и властвуй»
- Код с рекурсией получается значительно проще и понятнее
Примеры: обход дерева, быстрая сортировка, поиск в глубину, backtracking
Используйте циклы, когда:
- Важна производительность и эффективность использования памяти
- Задача естественным образом описывается последовательностью шагов
- Глубина рекурсии может быть очень большой
Примеры: обработка массивов, вычисления с накоплением, простые итерации
Что такое стек
Все вызовы функций в нашем коде хранятся в специальной структуре – стеке вызовов функций. Прежде чем говорить о стеке вызовов, разберём обычный стек как структуру данных. Стек хранит элементы в порядке LIFO: последний добавленный элемент извлекается первым.
Представьте историю переходов в приложении. Каждый новый экран кладётся поверх предыдущего. Кнопка «Назад» снимает верхний экран и возвращает тот, который лежал под ним.
У стека обычно выделяют три операции: push добавляет элемент на вершину, pop снимает верхний элемент, peek позволяет посмотреть на вершину, не удаляя её.
В Python отдельного встроенного типа Stack нет: для собственного стека часто используют список. Метод append играет роль push, а метод pop снимает последний элемент.
stack = []
stack.append("A")
stack.append("B")
stack.append("C")

print(stack.pop())  # C
print(stack.pop())  # B
До элемента A мы не доберёмся раньше C и B. Именно такой порядок понадобится интерпретатору, чтобы правильно продолжить вложенные вызовы функций.
Как работает стек вызовов
Стек вызовов — это применение того же принципа к работающим функциям. На вершине находится функция, которую Python выполняет прямо сейчас. Под ней ждут функции, вызвавшие её.
Для каждого вызова создаётся кадр стека, или фрейм. В нём хранятся аргументы, локальные переменные, место возврата и всё, что понадобится для продолжения работы.
У factorial(5) во фрейме лежит n = 5 и незавершённое умножение 5 · ?. Во фрейме factorial(4) лежит n = 4 и выражение 4 · ?. Эти фреймы независимы: у каждого своё n.
Каждый вызов функции должен «помнить» свои аргументы, локальные переменные и место, с которого нужно продолжить работу. Эта информация хранится в стеке вызовов.
Стек похож на стопку тарелок: новую тарелку кладут сверху, и первой снимают тоже верхнюю.
Это принцип LIFO: Last In, First Out — «последним вошёл, первым вышел».
- push — поместить новый вызов на вершину стека;
- pop — снять завершившийся вызов с вершины.
Поэтому последний запущенный вызов завершается первым.
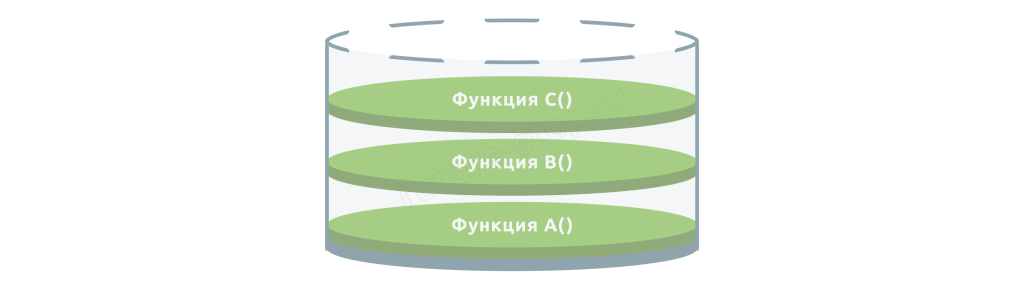
Допустим, у нас есть три функции:
def A():
    B()
def B():
    C()
def C():
    pass
Графически эти вызовы можно представить следующим образом:
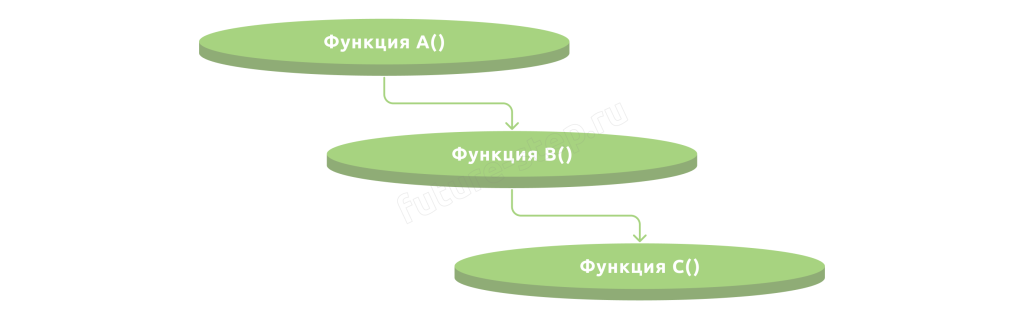
Когда A вызывает B, вызов A остаётся в стеке и ждёт. Затем B так же ждёт C.
Когда C завершается, её вызов удаляется из стека. Затем продолжается выполнение функции B, а после неё — A.
Стек вызовов трёх наших функций можно представить в виде вот такого контейнера с «блинчиками»—функциями.
С factorial(5) происходит то же самое: пять вызовов накапливаются в стеке.
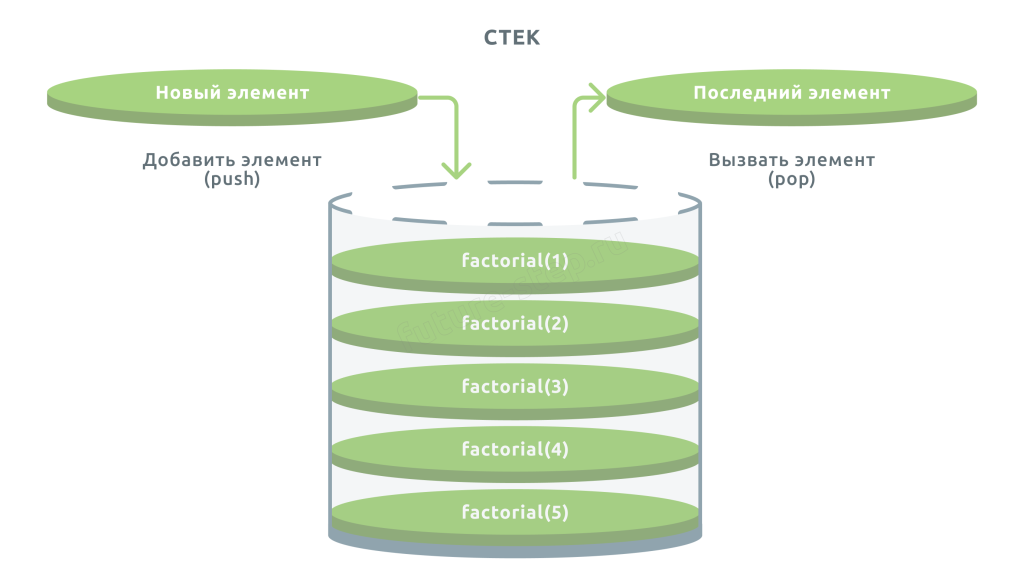
На вершине нашей стопки «блинчиков»-функций оказывается factorial(1). Вызов этой функции возвращает 1. После этого по очереди продолжаются уже ожидающие factorial(2), factorial(3), factorial(4) и factorial(5).
Можно представить последовательность так: push factorial(5), push factorial(4), push factorial(3), push factorial(2), push factorial(1). После базового случая начинается серия pop в обратном порядке.
При каждом pop Python возвращается ровно к тому месту, где предыдущий вызов остановился. Поэтому сначала вычисляется 2 · 1, затем 3 · 2, потом 4 · 6 и только в конце 5 · 24.
Каждый такой вызов занимает место в памяти, поэтому глубина стека не может расти бесконечно.
В Python до переполнения системного стека обычно срабатывает защита и возникает RecursionError.
Предел рекурсии
В Python есть ограничение на глубину рекурсии. Во многих установках его начальное значение равно 1000, но надёжнее всего узнать его у самого интерпретатора.
Для этого используем getrecursionlimit:
import sys

print(sys.getrecursionlimit())
>>> 1000  # стандартное значение
Это не означает, что можно безопасно сделать ровно 1000 своих рекурсивных вызовов: часть глубины уже занята другими вызовами Python. То есть в стек вызовом можем сложить стопку из тысячи «блинчиков»–функций.
Поэтому даже factorial(1000) при лимите 1000 закончится ошибкой:
def factorial(n):
    if n <= 1:
        return 1
    return n * factorial(n - 1)

print(factorial(1000))

>>>RecursionError: maximum recursion depth exceeded
Лимит нужен как защита от слишком глубокой или бесконечной рекурсии.
Например, здесь забыли базовый случай:
def broken_function():
    broken_function()
Без защиты каждый новый вызов продолжал бы занимать память, пока она вовсе не закончилась во всей системе.
Если видите RecursionError, сначала проверьте базовый случай и направление изменения n. Не спешите сразу поднимать лимит!
Для поиска ошибки полезно временно печатать аргумент в начале функции. Если числа удаляются от базовой границы или начинают повторяться, направление рекурсивного шага выбрано неверно.
Ещё одна частая ошибка — базовый случай существует, но не охватывает всю цепочку вычислений. Например, вызовы уменьшают n на 2, базовый случай задан только для n == 0, а стартовое n нечётное. Цепочка пройдёт 1, −1, −3 и никогда не попадёт в ноль.
Что делать с большой глубиной
Если рекурсия записана верно, но вызовов слишком много, есть три пути:
- переписать вычисление через цикл;
- изменить алгоритм, чтобы уменьшить глубину;
- осторожно увеличить лимит, если глубина известна и невелика.
Переписать алгоритм церез цикл можно, если понимаете как из рекурсии вывести формулу для итеративного вычисления. Мы так уже делали в примерах выше.
Изменить алгоритм здесь означает использование специальной техники оптимизации, которая называется «мемоизация», но он ней мы поговорим в следующей статье, убирает повторные вычисления. Но сама по себе она не уменьшает длину одной цепочки вызовов.
Лимит можно изменить функцией sys.setrecursionlimit. Это самое простое, но не самое оптимальное, что можно сделать в таких случаях. Продемонстрируем это далее.
Для factorial(1000) нужен запас, поэтому установим не 1001, а, например, 2000:
import sys

sys.setrecursionlimit(2000)

def factorial(n):
    if n <= 1:
        return 1
    return n * factorial(n - 1)

print(factorial(1000))
Теперь вычисление пройдёт, но сам лимит не делает алгоритм быстрее и не уменьшает расход памяти. К тому же, поднимать лимит до огромных значений опасно: ограничен не только Python, но и системный стек. При чрезмерном значении программа может завершиться аварийно, не успев выдать обычный RecursionError.
Поэтому перед изменением лимита убедитесь в трёх вещах:
- базовый случай точно достижим;
- максимальная глубина заранее понятна;
- переписать задачу через цикл нельзя или это заметно усложнит решение.
А для 16 заданий ЕГЭ лучше всегда прибегайте к использованию мемоизации, даже не надеясь на использование setrecursionlimit.
Итоги
Рекурсивная функция решает задачу через более простой вызов самой себя. Чтобы она завершилась, нужен достижимый базовый случай и движение аргумента к нему. Во время спуска вызовы накапливаются в стеке, а затем продолжаются в обратном порядке.
Всегда сначала проговаривайте цепочку на маленьком аргументе. Проверьте, какие значения попадают в отдельные фреймы, что остаётся ждать после рекурсивного вызова и где начнётся обратный путь. В следующей статье посмотрим, почему ветвящаяся рекурсия повторяет одни и те же вычисления и как мемоизация избавляет нас от этой работы.