 Алгоритм решения задания 14. Часть 1
Учимся решать 15 задания первого типа
Читать
Кодирование информации
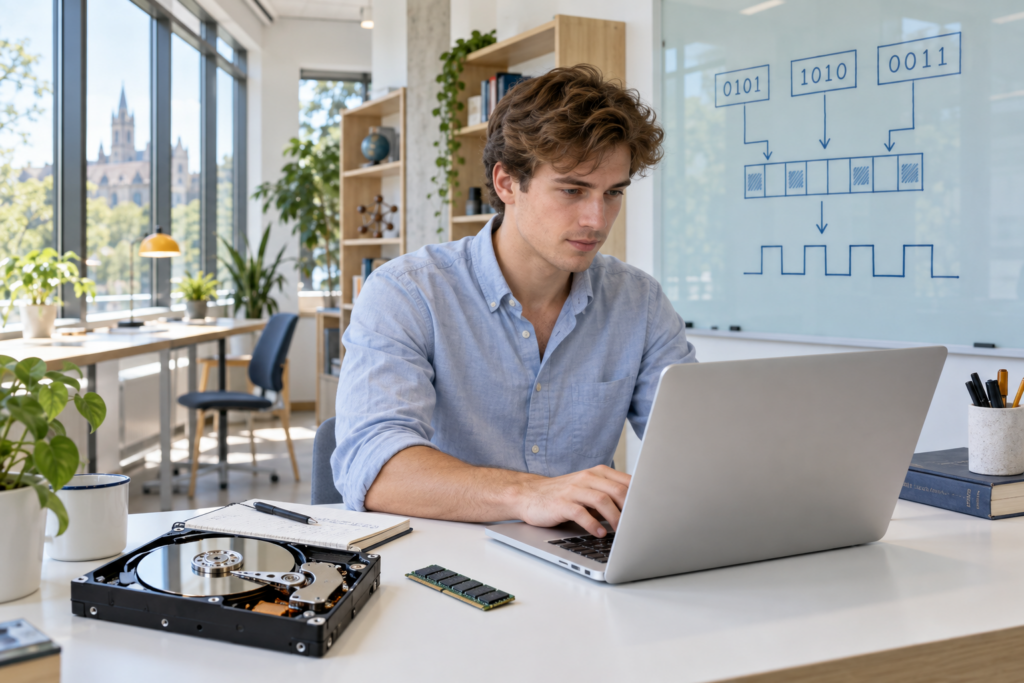
Сегодня мы разберёмся с тем, как работает кодирование информации. За простым набором нулей и единиц скрывается целый мир: от того, как устроена память компьютера, до того, почему текст на экране иногда превращается в непонятный набор символов. Мы шаг за шагом посмотрим, как данные записываются и считываются с жёсткого диска, как работает головка чтения-записи и что вообще означает намагниченность в контексте хранения информации.
Мы рассмотрим, как протекают физические процессы на уровне железа. Причём это не про сленговое название комплектующих компьютера, а про реальные материалы внутри накопителей. Узнаем, как физические состояния носителя превращаются в цифровой сигнал из нулей и единиц. Знание таких основ – это настоящий фундамент, так называемая база всей информатики.
Мы обсудим, как из этих нулей и единиц собираются числа, буквы и даже сложные мультимедийные файлы. Поговорим о кодировках текста: почему компьютер «понимает» символы только в виде чисел, чем отличается ASCII от Unicode и UTF-8, и почему иногда вместо привычного текста вы видите странные квадратики или нечитаемые значки, если кодировка «сбилась».
Наконец, мы разберём более теоретические вещи: что такое однозначное декодирование, зачем нужно равномерное кодирование и при чём здесь условие Фано. Эти понятия встречаются в заданиях по информатике, но на самом деле объясняют базовые правила того, как информация превращается в удобный и надёжный для хранения и передачи вид.
Информация в железе
Память компьютера, независимо от того, жёсткий диск это или электронные микросхемы памяти вроде SSD или оперативной памяти, хранит данные только в цифровом виде. То есть вся информация – текст, изображения, музыка или видео – представлена последовательностью сигналов двух уровней: высокого и низкого. Эти сигналы легко интерпретируются как нули и единицы, а дальше уже строятся более сложные структуры: байты, файлы, базы данных.
Рассмотрим устройство жёсткого диска (HDD). Он состоит из нескольких ключевых компонентов:
- Корпус, который защищает внутренние элементы от пыли и повреждений;
- Магнитные диски (пластины), на которых и хранится информация;
- Головки чтения/записи, которые «пишут» и «читают» данные;
- Двигатель, который раскручивает пластины с большой скоростью.
Наиболее интересны для нас сами магнитные пластины, ведь именно на них физически хранится информация. Обычно основу пластины делают из алюминия или стекла, а сверху наносят тонкий слой ферромагнитного материала. Этот слой способен сохранять направление намагниченности.
На поверхности диска информация хранится в виде последовательности битов. Если немного упростить, микроскопические участки магнитного слоя могут быть намагничены в двух направлениях, которым соответствуют нули и единицы:
- Одно направление намагниченности → логическая единица (1);
- Другое направление намагниченности → логический ноль (0).
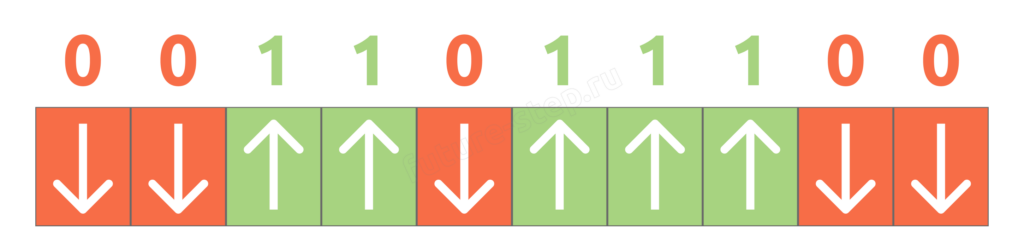
Когда нужно записать данные, головка создаёт сильное локальное магнитное поле, которое ориентирует маленький участок ферромагнитного материала в нужном направлении. Если данные нужно изменить, то на этом же участке вектор намагниченности может быть переориентирован в другую сторону.
Чтение данных происходит обратным образом: головка фиксирует изменения магнитного поля при движении пластины. Сенсор преобразует их в электрические сигналы, а контроллер диска восстанавливает по этим сигналам последовательность нулей и единиц.
Таким образом, жёсткий диск превращает физическое свойство материала – намагниченность – в цифровую информацию. Буквально крошечные участки сплава на пластине хранят всю библиотеку компьютера, а головка «воспринимает» их как простые нули и единицы.
После того как мы поняли, как отдельные участки пластины намагничены и представляют собой биты, логично задаться вопросом: а как эти миллионы битов организованы, чтобы компьютер мог быстро их находить и считывать? Для этого в жёстком диске используется иерархическая структура хранения информации.
Поверхность каждой пластины разбита на концентрические окружности, которые называют дорожками. Вдоль каждой дорожки расположены последовательности битов. Разные дорожки отделены друг от друга небольшими зазорами, чтобы головка не считывала соседнюю дорожку по ошибке.
Дорожки, в свою очередь, делятся на более мелкие участки – сектора. Физический сектор обычно содержит 512 или 4096 байт. Данные считываются и записываются блоками, а нужные блоки контроллер находит по их адресам.
Когда нужно прочитать какой-либо файл, контроллер диска вычисляет, какие дорожки и сектора содержат нужные данные, и перемещает головку к соответствующему сектору.
Стоит отметить, что в жёстком диске может быть несколько магнитных пластин, расположенных друг над другом. Данные записываются на рабочие поверхности пластин, и у каждой поверхности есть свои дорожки и сектора.
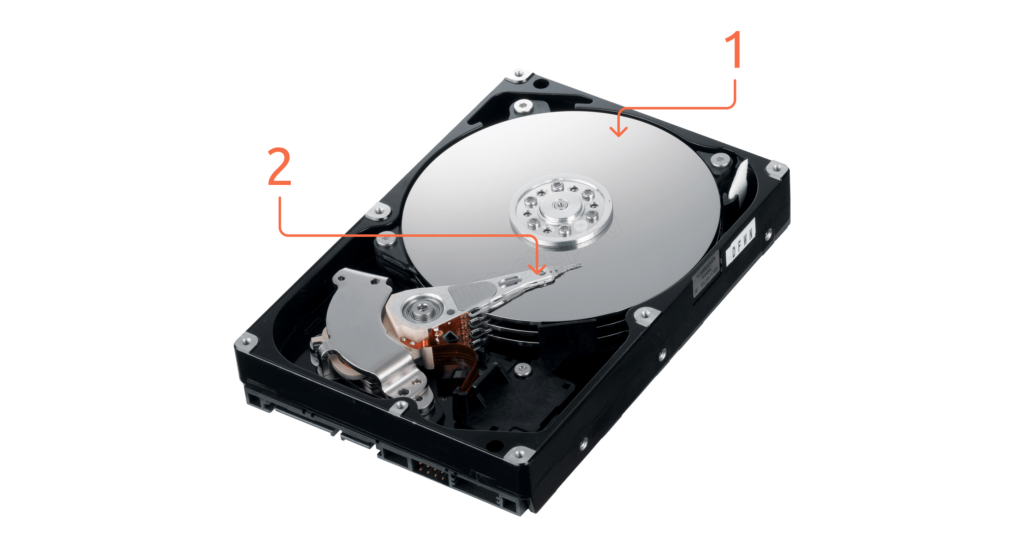
Использование нескольких пластин увеличивает объём памяти: чем больше рабочих поверхностей, тем больше данных можно записать в одном устройстве. Над каждой рабочей поверхностью находится своя головка чтения-записи. Все головки перемещаются синхронно, но в конкретный момент данные обычно читает или записывает одна выбранная головка.
Дорожки одинакового радиуса на разных рабочих поверхностях образуют цилиндр. Если представить это в 3D, цилиндр – это вертикальный «столбик» из дорожек, над которыми головки оказываются без дополнительного перемещения блока головок.
Благодаря такой структуре контроллер диска может находить запрашиваемые данные. Современная система обращается к логическим блокам, а сам накопитель уже сопоставляет их с физическими областями пластин.
Когда данные считываются, магнитная головка фиксирует изменения магнитного поля, преобразует их в электрический сигнал, а контроллер восстанавливает привычные нам байты, из которых состоят файлы.
Таким образом, дорожки и сектора образуют физическую структуру хранения данных, а понятие цилиндра помогает представить расположение дорожек на нескольких поверхностях. Без такой организации быстро найти нужную информацию было бы невозможно.
Цифровые сигналы
После того как мы разобрались с устройством жёсткого диска, логично перейти к электронным накопителям и понять, как информация хранится там. В HDD используются магнитные состояния, а в SSD – уровни электрического заряда в ячейках памяти.
В твердотельных накопителях данные хранятся в ячейках флеш-памяти: заряд изменяет пороговое напряжение транзистора. В простейшем случае контроллер различает два состояния:
- Один диапазон порогового напряжения соответствует логической единице (1).
- Другой диапазон соответствует логическому нулю (0).
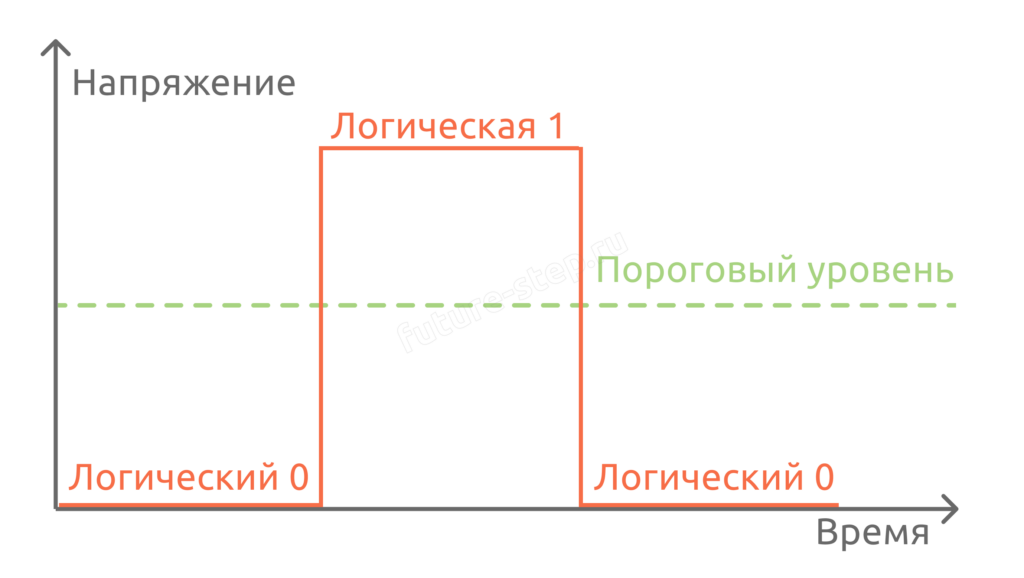
Физически заряд и напряжение могут принимать разные значения, но контроллер относит измеренное значение к определённому диапазону. В современных SSD одна ячейка может различать не два, а несколько уровней и поэтому хранить несколько битов.
Именно поэтому вся информация в компьютере, независимо от носителя, хранится в двоичной системе счисления. Любой текст, изображение, звук или видео сначала переводятся в последовательность нулей и единиц.
Главное преимущество цифрового подхода в том, что он устойчив к шуму и небольшим искажениям. Даже если напряжение немного колеблется, пока оно остаётся выше или ниже порога, компьютер корректно интерпретирует бит. Благодаря этому устройства могут надёжно хранить и быстро обрабатывать огромные объёмы информации.
Таким образом, жёсткий диск использует магнитные состояния для кодирования данных, а SSD – различные уровни электрического заряда. В обоих случаях контроллер преобразует физические состояния в последовательность битов.
Декодирование
Если компьютеру удобно хранить данные в виде нулей и единиц, то как же человеку тогда понимать эту же информацию? Для этого применяется обратная операция – декодирование.
Декодирование – это процесс, обратный кодированию. Он заключается в преобразовании закодированной информации обратно в исходный вид.
Проще говоря, компьютер читает последовательности нулей и единиц и переводит их в знакомые нам символы, текст, изображения или звук. Благодаря декодированию мы можем видеть на экране слова, слушать музыку и работать с файлами, даже если на самом деле всё это хранится в виде двоичных данных.
Например, возьмём слово «Привет». Когда мы вводим его в компьютер, оно сначала преобразуется в последовательность нулей и единиц. В популярной кодировке UTF-8 это будет так:
11010000 10011111 11010001 10000000 11010000 10111000 11010000 10110010 11010000 10110101 11010001 10000010
Каждый блок из 8 нулей и единиц – это байт, а комбинации байтов кодируют конкретные символы. При выводе на экран компьютер декодирует эти байты обратно в привычный текст «Привет».
Важно понимать, что для правильного декодирования нужно знать кодировку, в которой данные были сохранены. Если программа выбрала другую кодировку, на экране появляются непонятные символы: одни и те же байты интерпретируются не по тем правилам.
Однозначное декодирование
Но вернёмся к нашему закодированному слову «Привет». Как же компьютер понимает, что набору символов «11010000 10011111» соответствует именно буква «П», а не любое другое значение?
Это работает за счёт того, что код допускает однозначное декодирование.
Однозначное декодирование – это свойство кода, при котором по закодированной последовательности можно восстановить только одно исходное сообщение. Иными словами, поток битов можно разбить на кодовые слова единственным способом.
Простой пример: пусть у нас есть кодировка, где букве «А» соответствует 0, букве «Б» – 10, букве «В» – 11. Если мы прочитаем последовательность 010, мы точно знаем, что она расшифровывается как «АБ» (0 – A, 10 – Б), а не как «ВА» или какой-то другой набор.
Это и есть однозначное декодирование: одна и та же последовательность битов не может обозначать два разных сообщения.
Теперь рассмотрим неоднозначный код: пусть букве «А» соответствует 0, букве «Б» – 01, букве «В» – 1. Попробуйте теперь расшифровать последовательность 011!
Это может быть любой из двух вариантов:
- АВВ
- БВ
То есть здесь невозможно однозначно понять, какое сообщение было закодировано. Любая попытка декодирования приводит к двусмысленности, и компьютер не сможет корректно восстановить исходное сообщение.
К однозначной дешифровке мы вернёмся немного позже. А пока обратите внимание: в слове «Привет» каждая русская буква в UTF-8 занимает по 2 байта. Но сама кодировка UTF-8 не является равномерной: разные символы в ней могут занимать от 1 до 4 байт.
Давайте разбираться.
Равномерное кодирование
Простой пример равномерного кодирования – таблица, в которой каждому символу заранее отведено одинаковое количество битов. Например, если все кодовые слова имеют длину 8 бит, границы между символами всегда находятся через каждые 8 бит.
Равномерное кодирование – это метод, при котором все символы или сообщения кодируются одинаковым количеством битов. Другими словами, каждый символ имеет фиксированную длину кода.
Равномерное кодирование легко реализовать и удобно использовать. Оно эффективно работает при передаче данных по каналам связи с фиксированной пропускной способностью.
Однако у равномерного кодирования есть и недостаток: часто и редко встречающиеся символы занимают одинаковое место. Например, буква «А» будет занимать столько же памяти, сколько и буква «Ъ», которая встречается гораздо реже.
Для сжатия данных было бы выгоднее часто встречающимся символам назначить короткие коды, а редким – более длинные.
Так сообщение может занимать меньше памяти, чем при равномерном кодировании. Такой принцип используется в неравномерных кодах.
Неравномерное кодирование – это метод, при котором кодовые слова могут иметь разную длину. В кодах для сжатия часто встречающимся символам обычно назначают более короткие коды, а редким – более длинные.
Представим, что у нас есть алфавит из трёх букв: A, B и C. Назначим им такие кодовые слова, удовлетворяющие условию Фано:
- A – 0, то есть 1 бит;
- B – 10, то есть 2 бита;
- C – 11, то есть 2 бита.
Тогда слово «ACABAB» займёт 9 бит: 1 + 2 + 1 + 2 + 1 + 2. Часто встречающаяся буква A получила самый короткий код, поэтому сообщение стало компактнее.
А теперь распределим длины менее удачно, но всё ещё сохраним условие Фано:
- A – 110, то есть 3 бита;
- B – 10, то есть 2 бита;
- C – 0, то есть 1 бит.
Теперь то же сообщение «ACABAB» займёт уже 14 бит: 3 + 1 + 3 + 2 + 3 + 2. При равномерном двухбитном кодировании оно заняло бы 12 бит. Поэтому важно не просто выбрать разные длины, а разумно распределить их между символами.
А какой код нам выбрать для каждой буквы? Мы уже ранее говорили, что у нас должно быть однозначное декодирование, но в чём оно заключается?
Как мы уже выяснили, однозначное декодирование гарантирует, что вся последовательность битов разбивается на кодовые слова только одним способом.
Но при неравномерном кодировании символы имеют разную длину, и здесь легко допустить ошибку: часть кода одного символа может совпасть с началом кода другого, как это было в примере про буквы «А», «Б» и «В».
Чтобы гарантировать отсутствие двусмысленности и корректно восстановить сообщение, удобно использовать условие Фано.
Условие Фано
Условие Фано гласит, что никакое кодовое слово не может быть началом другого кодового слова. Если соблюдать это правило, последовательность можно однозначно декодировать слева направо, сразу определяя границы символов.
Представьте, что букве «А» соответствует код 0, букве «Б» – 01, а букве «В» – 1. Код «А» является началом кода «Б», поэтому условие Фано нарушено. Последовательность 01 можно прочитать и как «Б», и как «АВ».
Существует и обратное условие Фано: никакое кодовое слово не должно быть окончанием другого. Оно позволяет так же однозначно декодировать сообщение, но уже справа налево.
Выполнение прямого или обратного условия Фано гарантирует однозначное декодирование даже длинного потока битов.
Отсюда получаются два важных понятия: префиксный и постфиксный коды. В префиксном коде ни одно кодовое слово не является началом другого, а в постфиксном – окончанием другого.
Условие Фано – это удобный достаточный признак однозначного декодирования. Существуют однозначно декодируемые коды, которые ему не соответствуют, но в задании 4 ЕГЭ работают именно с условием Фано.
Благодаря этому правилу можно быстро проверять наборы кодовых слов и безошибочно восстанавливать исходные символы.
А грамотно распределять кодовые слова по буквам и применять условие Фано мы научимся далее, при разборе алгоритма решения задания 4 ЕГЭ по информатике.
Но для распределения кодовых слов нам необходимо научиться правильно строить двоичные деревья, чему и посвящена следующая статья.