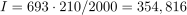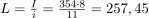Задание 11 ЕГЭ по информатике нацелено на проверку умений учащихся подсчитывать информационный объём сообщения. Это задание в целом очень похоже на рассмотренное ранее задание 7, где требовалось подсчитать вес изображения, звукового или видеофайла.
Но в случае с 11 заданиями, мы будем работать только с текстовой информацией. Это во многом упрощает решение задания 11, однако, в нём присутствует ряд моментов, на которые стоит обратить внимание, чтобы не случайно не допустить ошибку в ответе.
В заданиях 11 обычно вы можете столкнуться с тремя формулировками условий:
Определить минимально / максимально возможную длинусерийного номера / идентификатора
Определить объём памяти, необходимый для хранения заданного числа серийных номеров / идентификаторов
Определить минимально / максимально возможную мощность алфавита
Как вы уже могли догадаться, каждой из этих формулировок будет посвящена отдельная статья. Сегодня же мы поговорим про нахождение длины серийного номера или идентификатора.
Тип 1. Объём текстового сообщения
В первом типе требуется найти минимально или максимально возможную длину пароля, идентификатора либо серийного номера.
Действуем по цепочке: считаем мощность алфавита, находим число бит на символ, определяем допустимый размер одного сообщения в байтах и только затем переходим к его длине.
Объём текстового сообщения
Итак, в прошлой статье, мы уже разобрались с тем, как хранится информация на компьютере и как найти вес одного символа, зная мощность алфавита. Сейчас мы не будем останавливаться на этом, так что настоятельно рекомендуем ознакомиться с прошлой статьёй и освежить знания.
С символом-то мы уже умеем работать, но, как нетрудно догадаться, одного символа нам явно не хватит, чтобы закодировать нужное сообщение. Этим сообщением, к примеру, может быть как любая текстовая информация, так и пароль, идентификатор или серийный номер изделия.
Что мы знаем точно, так это то, что у этого сообщения должна быть определённая длина — количество символов, из которых состоит каждое сообщение. Тогда, зная вес одного символа (i) и длину сообщения (L), можем вычислить и объём всего сообщения (I):
Если же требуется определить максимально возможную длину одного сообщения (или как в 11 заданиях, длину серийного номера / идентификатора), то из формулы выше выразим значение L:
Если ищем максимальную длину при ограничении сверху, дробную часть отбрасываем. Если ищем минимальную длину для превышения порога, проверяем первый целый вариант, который выполняет неравенство.
Алгоритм решения
Решать 11 задания можно двумя способами:
Вычислить длину по формулам вручную или в Python.
Перебирать целые значения L и проверять исходное условие целиком.
Оба способа полезны. Формула быстрее, а перебор удобен как проверка, если вы сомневаетесь в округлении.
Пример 1. Ручное решение
Итак, начнём мы, конечно же, с самого распространённого и практичного решения – ручного. Первым у нас будет задание с такой формулировкой:
На предприятии каждой изготовленной детали присваивают серийный номер, содержащий десятичные цифры, 52 латинские буквы (с учётом регистра) и символы из 963-символьного специального алфавита. В базе данных для хранения каждого серийного номера отведено одинаковое и минимально возможное число байт. При этом используется посимвольное кодирование серийных номеров, все символы кодируются одинаковым и минимально возможным числом бит. Известно, что для хранения 2000 серийных номеров отведено не более 693 Кбайт памяти.
Определите максимально возможную длину серийного номера.
Давайте распишем решение этого задания полностью, как если бы мы решали его на бумаге. Для начала найдём мощность алфавита (N):
N = 10 цифр + 52 латинские буквы + 963 спецсимвола = 1025 символов
Сравниваем N со степенями двойки: 210 = 1024, а символов 1025. Значит, 10 бит не хватает и берём i = 11 бит.
На все 2000 номеров выделено не более 693 Кбайт, вычислим I:
Округляем вниз из-за слов «не более». Если взять 355 байт, общий объём превысит ограничение. Разберёмся, почему – на все сообщения у нас выделено не более 693 Кбайт. В таком случае, если вес сообщения будет 355 байт, то 2000 таких сообщений будут весить примерно 693, 35 Кбайт, что нарушает условие задания. Следовательно, здесь вес одного сообщения нужно округлять в меньшую сторону (354 байт)!
В 354 байтах содержится 354 · 8 бит. Вычислим значение L:
В ответе нас просят записать только целое число, следовательно, записываем 257.
Пример 2. Решение по формулам в Python
Далее мы рассмотрим решение 11 задания этого типа все теми же формулами, но считать будем не вручную, а расписывая все формулы в среде разработки Python.
Python помогает избежать арифметических ошибок, но направление округления всё равно нужно определить по условию.
Формулировка здесь будет следующая:
При регистрации в компьютерной системе каждому объекту присваивается идентификатор, содержащий десятичные цифры, 26 латинских букв в верхнем регистре и символы из 2013-символьного специального алфавита. В базе данных для хранения каждого идентификатора отведено одинаковое и минимально возможное число байт. При этом используется посимвольное кодирование идентификаторов, все символы кодируются одинаковым и минимально возможным числом бит. Известно, что для хранения 2050 идентификаторов отведено более 709 Кбайт памяти.
Определите минимально возможную длину идентификатора.
Импортируем функции ceil для округления вверх и log2 для двоичного логарифма:
from math import log2, ceil
Выпишем из условия мощность алфавита и вес 2050 идентификаторов:
N = 10 + 26 + 2013
I_2050 = 709 * 2 ** 10
Далее все, как и в ручном методе. Ищем вес одного символа и округляем значение до большего числа:
i = ceil(log2(N))
Рассчитаем вес одного идентификатора:
I = ceil(I_2050 / 2050)
Осталось лишь найти длину идентификатора (L) и вывести её на экран:
L = ceil(I * 8 / i)
print(L)
Весь код для решения этого задания будет таким:
from math import log2, ceil

N = 10 + 26 + 2013
I_2050 = 709 * 2 ** 10

i = ceil(log2(N))


I = ceil(I_2050 / 2050)

L = ceil(I * 8 / i)
print(L)
В результате работы программы на экран выводится ответ – 237.
Пример 3. Перебор длины
Итак, мы решили два задания, основываясь только на вычислениях по известным нам формулам. Но в 11 заданиях можно пойти и другим путём – перебирать длину сообщения в цикле и выводить на экран ту, которая будет удовлетворять условиям.
Нельзя сказать, что этот подход избавит вас от знаний формул. Но до него все же можно дойти логически, что мы постараемся и показать далее.
Формулировка 11 задания будет такая:
На предприятии каждой изготовленной детали присваивают серийный номер, содержащий десятичные цифры и символы из 17-символьного специального алфавита. В базе данных каждый серийный номер занимает одинаковое и минимально возможное число байт. При этом используется посимвольное кодирование серийных номеров, все символы кодируются одинаковым и минимально возможным числом бит. Известно, что для хранения 7 564 230 серийных номеров требуется более 31 Мбайт памяти.
Определите минимально возможную длину серийного номера.
Как обычно, импортируем нужные функции и выписываем данные значения:
from math import ceil, log2

alphabet = 17 + 10
nums = 7_564_230
memory_size = 31 * 2 ** 20
Перебираем длину от меньшей к большей. Первое значение, при котором общий объём станет больше 31 Мбайт, и будет минимальным ответом:
for serial_num_len in range(1, 1000):
Далее в цикле находим вес одного символа в битах (i) и округляем «вверх», назовём эту переменную bits:
bits = ceil(log2(alphabet))
Итак, сколько у нас весит серийный номер? Если у нас есть вес одного символа, то чтобы найти вес какого-то количества символов, нужно просто перемножить вес на количество, верно?
Давайте так и сделаем, только вместо известного количества символов подставим нашу переменную serial_num_len из цикла:
bytes_per_num = ceil(serial_num_len * bits / 8)
Это будет вес одного серийного номера в байтах, так что не забывайте про деление на 8!
В условии сказано «более 31 Мбайт», поэтому используем строгий знак >:
if nums * bytes_per_num > memory_size:
Если условие выполнится, то выводим найденную длину серийного номера и завершаем цикл:
print(serial_num_len)
        break
Весь код для решения этого задания выглядит так:
from math import ceil, log2

alphabet = 17 + 10
nums = 7_564_230
memory_size = 31 * 2 ** 20


for serial_num_len in range(1, 1000):
    bits = ceil(log2(alphabet))
    bytes_per_num = ceil(serial_num_len * bits / 8)
    if nums * bytes_per_num > memory_size:
        print(serial_num_len)
        break
Первым подходит значение L = 7. Его и записываем в ответ.
Итоги
В задачах на длину идентификатора сначала определяется число бит на символ. Затем перебирается длина и проверяется ограничение на общий объём памяти.
Шаблон решения
from math import ceil, log2

alphabet = *1
objects = *2
memory = *3

bits = ceil(log2(alphabet))
for length in range(*4):
    bytes_per_object = ceil(length * bits / 8)
    if objects * bytes_per_object *5 memory:
        print(length)
        break
Мы используем файлы cookie. Необходимые обеспечивают работу сайта: корзину и вход в личный кабинет. С вашего согласия мы также используем сервис Яндекс Метрика, чтобы анализировать посещаемость и улучшать сайт.
Подробнее — в политике конфиденциальности.